27 篇文章的站内搜索:81 KB 索引与一次 304
静态站没有后端,所以站内搜索必须想在前面:索引在构建期生成,匹配在浏览器里做。
这个博客的方案很朴素:一个 search.json + 前端子串匹配。27 篇文章跑下来够用,但拆开量一遍才发现,里面藏着一个”每次搜索都重新下载索引”的问题。
方案长什么样
构建期把每篇文章的标题、描述、正文和链接写成一个大 JSON:
[
  { "title": "…", "description": "…", "content": "…", "link": "/posts/…", "published": "…" }
]
前端打开搜索面板时 fetch("/search.json"),然后在内存里对每个字段做 indexOf:
for (const post of posts) {
  for (const field of [post.title, post.description, post.content]) {
    const index = fieldLower.indexOf(keywordLower);
    if (index !== -1) { /* 截取命中位置前后 40 字的摘要 */ }
  }
}
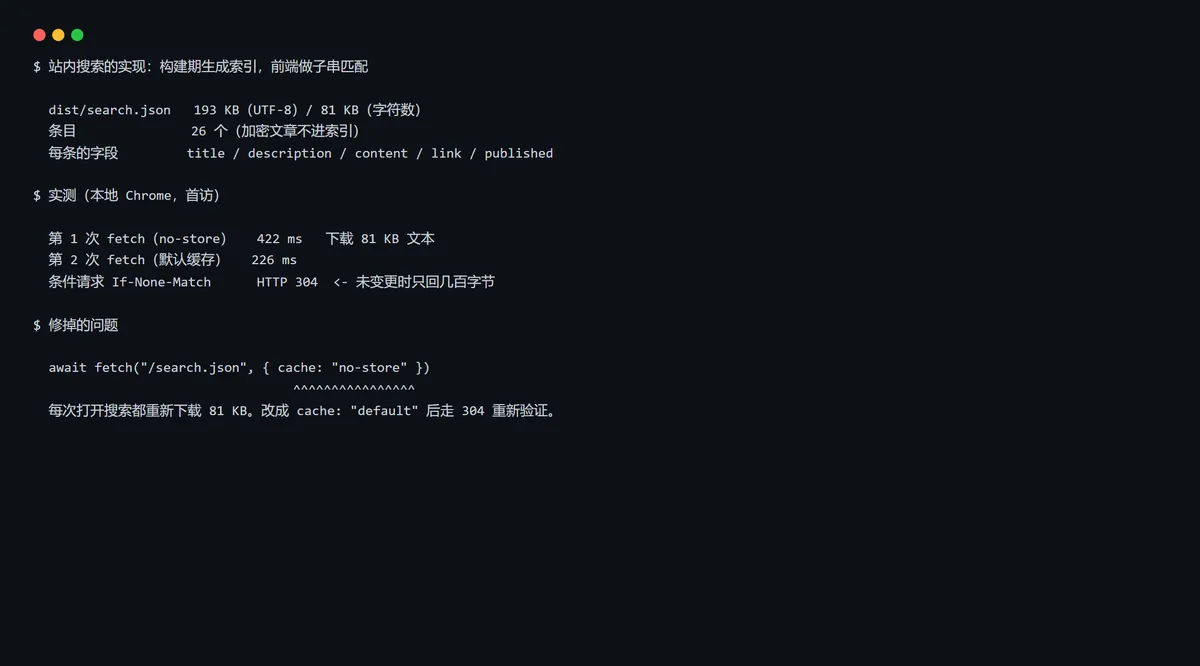
实测(本地 Chrome,首访):
| 指标 | 值 |
|---|---|
| 索引体积 | 193 KB(UTF-8)/ 81 KB(字符数) |
| 条目 | 26 篇(加密文章不进索引) |
| 首次 fetch | 422 ms(含下载) |
| 再次 fetch(默认缓存) | 226 ms |
修掉的那个问题:no-store
打开搜索面板的代码原本是:
await fetch("/search.json", { cache: "no-store" });
no-store 的意思是永远不要用缓存——于是每次打开搜索都重新下载 81 KB。对桌面宽带无所谓,对移动网络就是每次多几十 KB。
服务端给这个文件的是 cache-control: public, max-age=0, must-revalidate + ETag,也就是允许缓存但每次要验证。所以只要别写 no-store,浏览器就会带 If-None-Match 走条件请求:
GET /search.json
If-None-Match: W/"39bf20e5ce2f5db47093048c0770cc81"
→ HTTP 304 Not Modified(几百字节)
改成 cache: "default" 之后,第二次以后的搜索只花一次往返,不再传那 81 KB。
踩坑提示:
force-cache在这里不能用——索引文件名没有内容哈希,强缓存会读到发文章之前的旧索引。default+ 服务端 ETag 才是正确组合。
这套方案的天花板
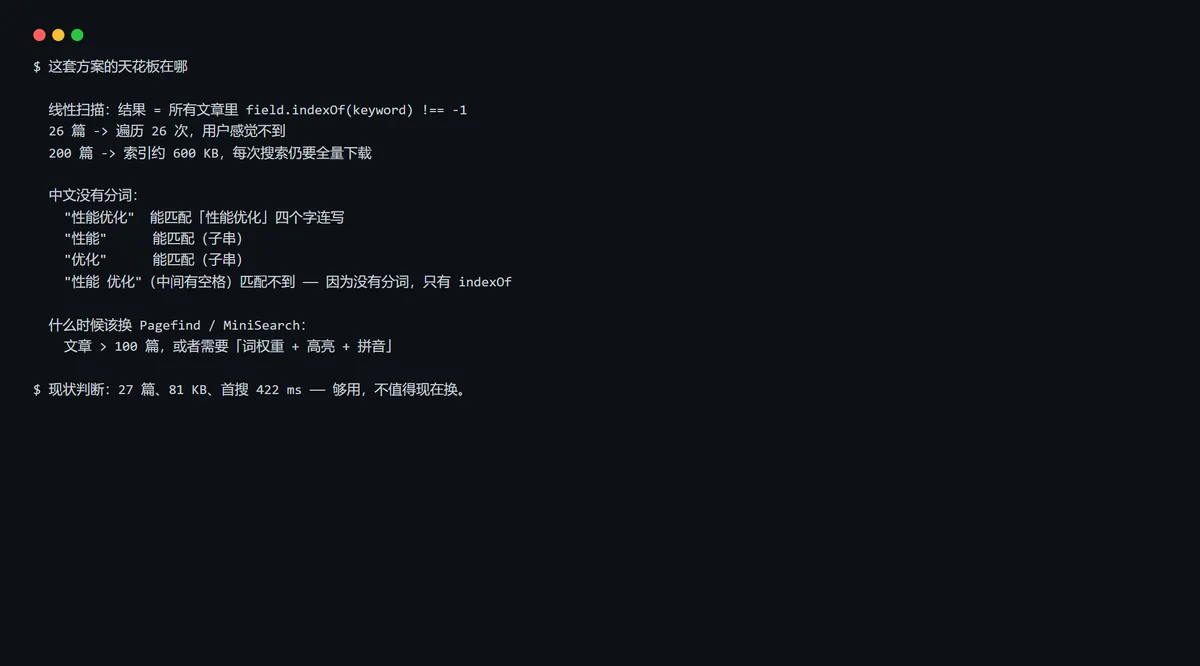
1. 线性扫描的代价随篇数增长。
26 篇时遍历 26 次,用户感觉不到。但索引是全量下载的——200 篇时大概 600 KB,每次搜索(哪怕只是第一次)都要传完才能搜。
2. 中文没有分词,只有子串匹配。
- 「性能优化」→ 能命中(四个字连写)
- 「性能」「优化」→ 也能命中(子串)
- 「性能 优化」(中间带空格)→ 命中不到
这不算 bug,但要知道它的边界:这套搜索本质是「整段文本包含关键词」,不是「按词检索」。
什么时候该换:文章超过 100 篇,或者需要词权重、高亮、拼音搜索。那时候该上 Pagefind(构建期生成倒排索引 + 分片加载)或 MiniSearch(前端建倒排索引)。现在 27 篇、81 KB、首搜 422 ms,不值得换。
一个取舍:索引里要不要放全文
现在 content 字段放了正文,所以:
- 好处:能搜到正文里的细节(比如某篇文章里提到的
cache-control); - 代价:索引随文章数线性变胖。
折中方案是只索引标题 + 描述 + 前 N 字。但那样会丢掉「搜正文」的能力,而技术博客里最常搜的恰恰是术语——所以我保留了全文,把「索引会不会太大」留给篇数增长时再决定。
小结
站内搜索不是”接个库”就完事,三个决定要先想清楚:
- 索引在哪生成:静态站只能在构建期(浏览器里建索引太慢);
- 怎么匹配:子串匹配足够简单,但要知道它不懂分词;
- 怎么缓存:索引是大文件,
no-store会让每次搜索都重下——用default+ ETag 走 304。
三条都记下来之后,这套 60 行的方案就能一直用到文章上百篇。
顺带一提,这套「构建期生成索引、浏览器里匹配」的思路,和构建产物与访客成本里讲的按需加载是同一个道理:能不进关键路径的,就别进。
发现错误或想要改进这篇文章?
在 GitHub 上编辑此页文章修订历史 (1 次)
查看变更记录
docs(baseline): 第 30 轮终检——数字更新到最终状态,补第 28~30 轮小结
相关文章
- 构建产物 16 MB,访客每次只下 28 KB统计 dist 目录发现 16 MB、313 个文件,其中 1.6 MB 的 Mermaid 图表引擎从来没被下载过。这篇把「部署体积」与「访客成本」分清:什么进了关键路径、什么按需加载、什么可以被缓存一年。
- 首屏从 392KB 砍到 59KB,FCP 从 7.4 秒到 2.1 秒用 CDP 模拟中端手机实测博客首页:GA4 与 Clarity 挤在关键路径、头像和 favicon 直接加载 107KB 原图、312KB 关键 CSS 拖慢首屏。四处改动后传输 392KB→59KB,FCP 7.4s→2.1s,长任务 13→2 个。
- 和 Cookie 横幅抢 LCP:我试到哪一步就停了上一篇发现真正的 LCP 元素是 Cookie 横幅后,我试了三种办法:提前加载、压缩体积 75%、preload 脚本。性能分从 37 提到 50、FCP 从 3.5s 到 1.5s,但 LCP 卡在 7.4s 不动。这篇记下为什么压小体积没用,以及我为什么停在这里。