文章配图流水线:截图、压成 WebP、随构建分发
写一篇带实测的技术文章,大概一半时间花在图上:截哪几张、截图里的数字对不对、压完还看不看得清、放进哪个目录。这些事重复十几次之后,必须有流水线——否则每次都要重新想一遍。
我这 13 篇文章一共 51 张配图、3.63 MB,全部走同一条流水线。规则只有四条。
规则一:截图必须是真实页面的
不做示意图、不用拼贴。写性能就打开 Chrome 的 Performance 面板或跑真实脚本,写 Cloudflare 就截控制台里的真实配置。文章里说「实测」的每一个数字,都要能在截图里找到。
截图工具是 Playwright + 本机 Chrome,必须 --headed —— 无头模式会被 Cloudflare 的浏览器校验拦住,截出来是一片空白。常用参数就几个:
# 整页截图,等 3 秒让懒加载与动画稳定,顺手隐藏 Cookie 横幅
node shot.mjs --url https://blog.peroe.cn/posts/xxx/ \
  --out ./02-post.png --width 1280 --height 900 --scroll 700 \
  --hide "#termsfeed-com---nb" --wait 3500
--hide 那一条是血泪:Cookie 横幅固定在底部,不藏掉会挡住正文的结论部分。
规则二:文件名就是出场顺序
配图放在 public/assets/images/posts/<slug>/,目录名与文章 slug 完全一致,文件按正文出现顺序编号:
public/assets/images/posts/blog-image-pipeline/
├── 01-convert.webp     ← 正文里第一张出现的图
├── 02-post.webp
└── 03-weight.webp
正文里用绝对路径引用(以 / 开头,走 public 目录):
目录名和 slug 不一致是最常见的 404 来源:文章能构建成功、图片全裂,而且本地开发时因为缓存还可能看着正常。
规则三:统一压成 WebP,宽度封顶
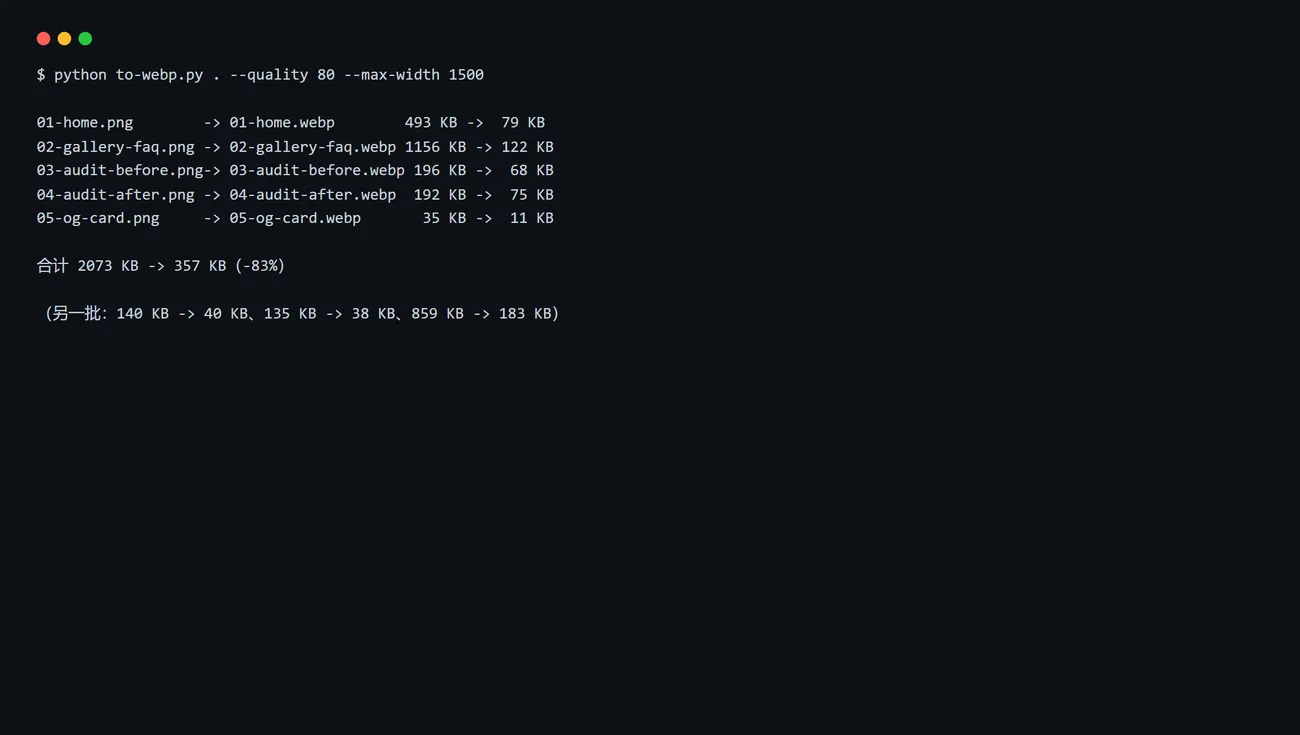
截图先存 PNG(无损、方便复核),再统一转 WebP:

我这批的压缩率是 83%,单张从几百 KB 降到一个屏都不一定用得完的大小。脚本做的事情很简单:Pillow 打开、convert("RGB")、save(quality=80)、限制最大宽度 1500px(截图放大就看不清字了,1500 够用)。
几个经验值:
| 类型 | 建议 | 原因 |
|---|---|---|
| 终端输出 / 表格 | 宽度 1000~1100、quality 80 | 等宽字体在高压缩下容易糊 |
| 网页截图 | 宽度 1280~1400、quality 80 | 再大就是浪费,页面本身按 1200 设计 |
| 图表 / 细线 | quality 85 | 细线在 WebP 里最先出现振铃 |
| 单张上限 | 300 KB | 超过就该考虑裁掉无关区域 |
规则四:图进仓库,不走图床
这是被讨论最多的一条。我选择把图片直接提交进仓库,理由是三个「不」:
- 不会跑图:图床跑路、防盗链、限速、跨域——这些问题全部消失,图片和 HTML 同源、同一套 CDN;
- 不依赖第三方:访客打开文章时,除了统计与评论,不再有任何外部图片请求;
- 构建时能校验:图片不存在,构建产物里就是一个 404 的
<img>,本地一看就知道。
代价是仓库体积。所以我给单张设了 300 KB 的上限(当前最大的一张 184 KB),并且只保留文章里真正用到的图——草稿截图、重复截图一律不进仓库。
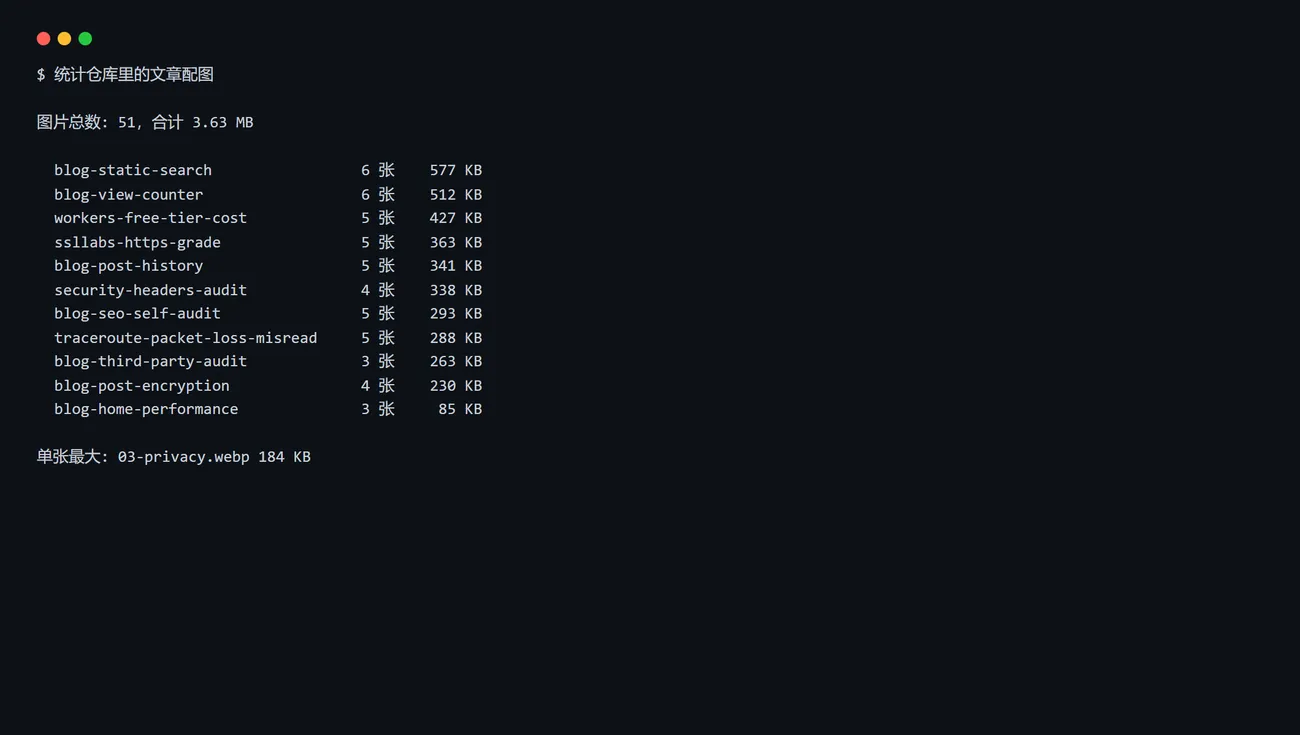
3.63 MB 对一个博客来说完全可以接受:它随构建分发,不占额外存储、不需要额外域名,也不会因为某个第三方服务挂掉而集体失效。
五个踩过的坑
1. 忘了按顺序编号。写完后插入了一张新图,编号乱了,正文里的 01/02/03 与目录对不上。解决办法是写完先列一遍图的位置,再统一编号。
2. 直接把 PNG 提交了。一张 1280×900 的网页截图 PNG 有 800 KB 到 1.2 MB,同样尺寸的 WebP 只有 40~120 KB。现在 public/ 里不允许出现 PNG 截图。
3. 目录名与 slug 不一致。改 slug 时忘了改目录,图片全 404。现在改 slug 会顺手 git mv 目录。
4. 截图里带着指纹信息。浏览器窗口标题栏、书签栏、系统时钟都可能泄露「这台机器是谁」。要么截图前隐藏,要么裁掉页头。
5. 正文里的数字与截图对不上。有一次脚本重跑后数字变了,正文还写着旧值。现在改完会重新截图,并把数字直接从脚本输出里抄——不要凭记忆写数字。
一条命令的收尾流程
现在的固定动作是这样:
# 1. 截图(headed,藏掉 Cookie 横幅)
node shot.mjs --url <文章地址> --out 02-post.png --width 1280 --hide "#termsfeed-com---nb"

# 2. 转 WebP(顺便限制宽度)
python to-webp.py . --quality 80 --max-width 1500

# 3. 确认体积(单张 < 300KB)
ls -lh *.webp

# 4. 写文章、引用、构建
pnpm astro build --force
四步走完,图的格式、体积、路径、命名就都是确定的——写正文时可以专心在内容上。
小结
配图流水线的价值不在「省时间」,而在让每次的结果一样:同样的命名规则、同样的压缩参数、同样的引用路径。当这些都不需要再想的时候,写文章才真正只剩下「把话说清楚」这件事。
三条可以立刻照抄的规则:真实截图(数字能对上)、顺序编号 + 目录同名(不会 404)、一律 WebP 且单张 < 300 KB(不拖慢文章页)。其余的(工具、参数)按自己的习惯换都行。
格式选择(继续用 WebP 还是上 AVIF)的实测数据在图片格式的收益边界。
发现错误或想要改进这篇文章?
在 GitHub 上编辑此页文章修订历史 (1 次)
查看变更记录
docs(baseline): 第 30 轮终检——数字更新到最终状态,补第 28~30 轮小结
相关文章
- 图片格式的收益边界:PNG → WebP → AVIF 实测拿自己站上 12 张真实配图做实验:WebP 换 AVIF 在「同画质」下平均省 35%,但常见的「AVIF 省一半」是拿不同质量档比出来的。附 PSNR 对齐方法、编码耗时与什么时候才值得上 AVIF。
- 随机图当封面:一张 250KB,我没让它进列表静态博客的卡片没图会很难看,随机图 API 看起来很省事。但实测那张图 250KB、Cache-Control 还是 max-age=0——如果首页 10 条卡片都挂上,一次访问就是 2.5MB。这篇算清这笔账,并给出三种封面方案的取舍。
- Astro 静态站的三个隐形约定:CSS 是全局的Astro 的默认行为大多很合理,但有三条不写在报错里的约定:script 默认被打包成模块、CSS import 默认对全站生效、dist 目录从不清理。每一条我都在这两周踩过,附判断命令与修法。