同一个站的两套统计,为什么差了 2.7 倍
本站装着两套访问统计,而且都是我自己在用的:
- Umami Cloud —— 从 2025 年就在记,跨域名迁移后历史保留;
- 自建 Worker + D1 —— 一个
tracker.js加一张pageviews表(pathname主键 +views)。
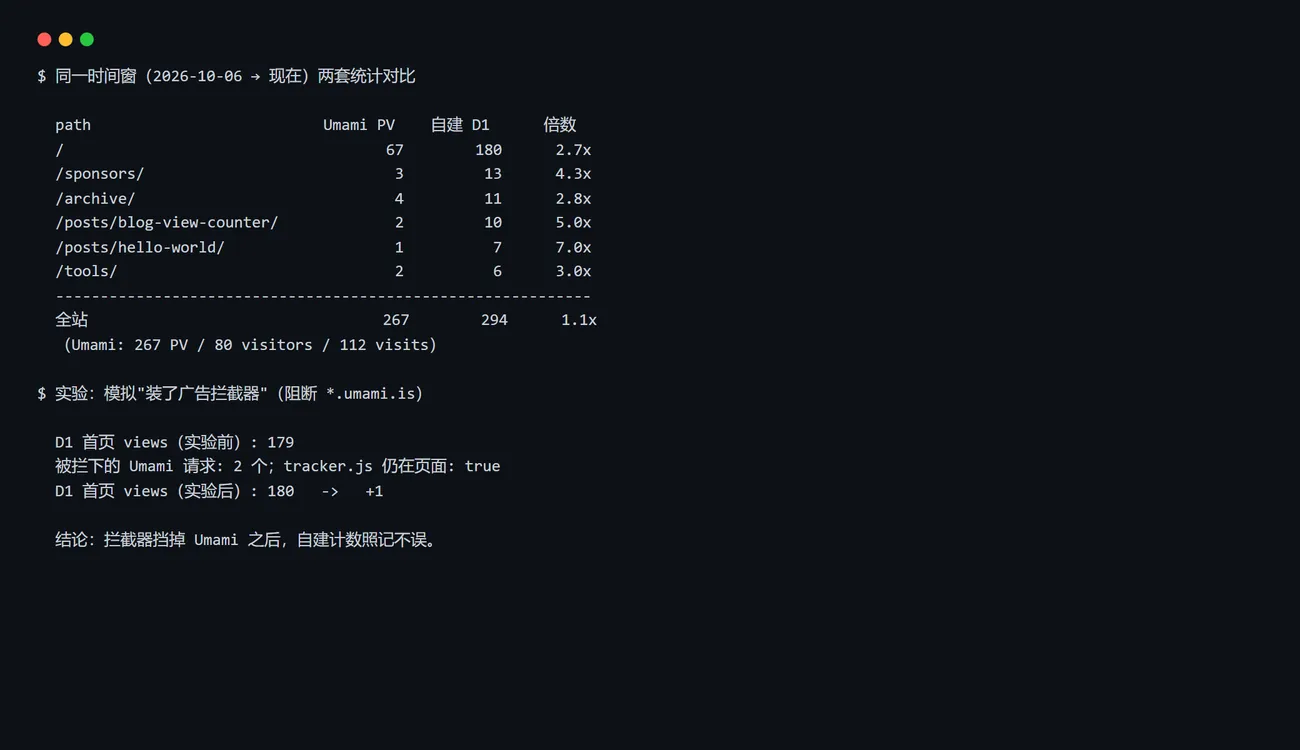
按理说它们看的是同一批访客。但把时间窗对齐到「迁移到 peroe.cn 之后」,同一段时间里首页被记了 67 次和 180 次。
先对齐口径,再谈差异
不同口径比大小没有意义,所以我做了三件事:
- 同一个时间窗:都从 2026-10-06(迁到新域那天)开始算 —— Umami 里还留着旧站
blog.peroe.top的历史,不截断的话它当然更大; - 同一个指标:都取 pageview(页面浏览次数),不拿 visitors / visits 去比;
- 同一个站点:都只看
blog.peroe.cn下的路径。
对齐之后,全站是 267 对 294 —— 差 10%,还算接近。但单个页面差得离谱:首页 67 vs 180(2.7 倍)、/posts/hello-world/ 1 vs 7(7 倍)。
实验:把 Umami 的域名挡掉
第一个怀疑对象是广告拦截器。cloud.umami.is 是个知名统计域名,uBlock、AdGuard 之类默认就会拦;而 t.peroe.cn 是我自己的域名,任何拦截列表里都没有。
验证方式很直接:用 Playwright 打开首页,把 *.umami.is 的请求全部 abort(模拟装了拦截器),然后看自建计数的表现:
await page.route("**://*.umami.is/**", (route) => route.abort());   // 模拟拦截

const before = 179;   // 实验前 D1 里 "/" 的 views
await page.goto("https://blog.peroe.cn/");
await page.waitForTimeout(9000);
// 实验后:D1 的 "/" 变成 180
结果:被拦下的 Umami 请求 2 个、自建计数 +1、Umami +0。
也就是说,装了拦截器的访客在两套统计里只留下一条记录 —— 他们的每一次访问,Umami 都看不见,而自建计数看得见。中文互联网上装拦截器的比例不低,这足以解释绝大部分差距。
另外三种会放大差距的机制
除了拦截器,还有三个我在实现里能确认的因素:
1. 脚本加载时机不同。 我把 GA4 与 Clarity 延后到 requestIdleCallback 才加载(见首屏优化那篇),Umami 的 script.js 也在那次改造后跟着延后;而 tracker.js 是页面一解析就执行。秒退的访客在 Umami 这边可能根本没等到 idle 就离开了。
2. bot 过滤不同。 Umami 会按 User-Agent 过滤已知爬虫;我的 tracker.js 只有一行 fetch,不做任何判断。这个站被扫描器盯得挺紧(Cloudflare 日志里每天都有几十个伪装 Googlebot 的请求打 /.env),它们大多不执行 JS,但只要有能跑 JS 的抓取器,自建计数就会虚高。
3. 我自己的自动化访问。 写这几篇文章的过程中,我在这台机器上把首页加载了上百次(截图、测性能、验证结构化数据)。每一次都是真实的一次 /send,也都有机会被 Umami 记上 —— 但它俩对”这次访问”的容忍度不同:我经常在页面刚 load 完就关掉浏览器,Umami 的 idle 回调还没跑。
那到底该信哪个
我的结论是:两个都不”错”,它们量的是不同的集合。
- Umami 更接近”人”:过滤爬虫、要求脚本加载完成,数字偏低但更像真实读者;
- 自建 D1 更接近”请求”:只要页面跑了 JS 就记,数字偏高但能覆盖被拦截器挡掉的那部分。
所以我把它们当区间用:真实访问量大概在「Umami 的 267」到「D1 的 294」之间,偏向 Umami 那一侧(因为拦截器用户毕竟还是少数,而我的自动化访问占了不少)。
展示哪个数字
站点侧栏显示的是 Umami 的数字:
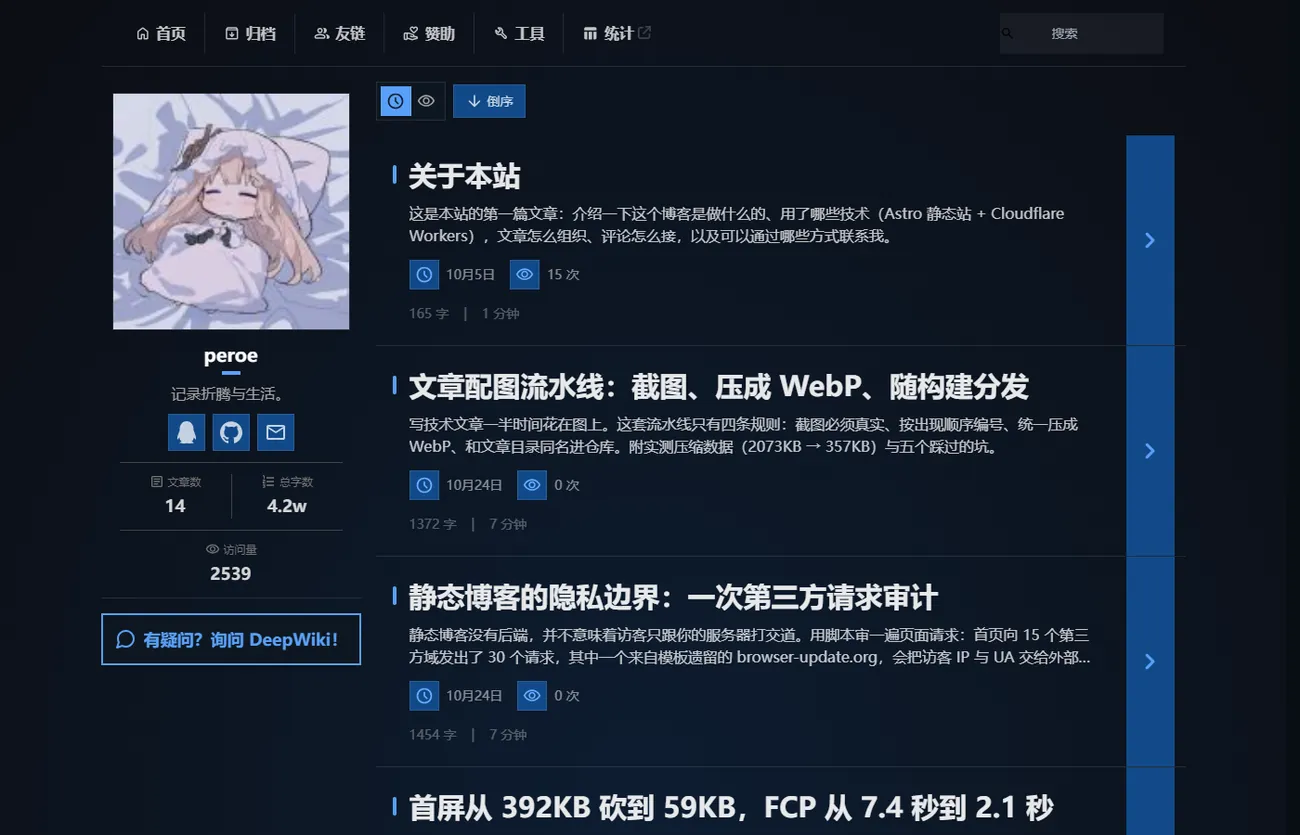
理由有两个:一是它跨域名迁移后历史连续(从 2025 年记到现在),读者看到的是一条平滑上升的曲线,而不是某天突然归零;二是它过滤了爬虫,数字更”干净”。
自建 D1 则退居兜底 —— 当某个路径 Umami 还没有数据(比如刚发布几分钟的新文章)时,才用它补一下。
如果你也想接两套统计
三条建议:
- 先对齐口径再比:截断时间窗、只比同一个指标,否则会得出”某套统计坏了”的错误结论;
- 把差异当成信息:两套的差就是”被拦截/被过滤的比例”,这本身比单一数字更有意思;
- 展示时选一个口径并写清楚:读者不需要知道你有两套统计,但你自己要知道屏幕上那个数字代表什么。
顺带一个实现细节:D1 的 HTTP 查询有几秒的读延迟,我刚发完一条就查会看不到。第一次实验我因此以为”自建计数没记上”,多等几秒才发现早就 +1 了 —— 排查计数问题时,先怀疑读延迟,再怀疑写入。
发现错误或想要改进这篇文章?
在 GitHub 上编辑此页文章修订历史 (1 次)
查看变更记录
docs(baseline): 第 30 轮终检——数字更新到最终状态,补第 28~30 轮小结
相关文章
- 静态博客的隐私边界:一次第三方请求审计静态博客没有后端,并不意味着访客只跟你的服务器打交道。用脚本审一遍页面请求:首页向 15 个第三方域发出了 30 个请求,其中一个来自模板遗留的 browser-update.org,会把访客 IP 与 UA 交给外部服务。附审计脚本与自查清单。
- 静态博客怎么显示每篇文章的浏览量:从 D1 读数接口到前端排序的完整链路静态站没有后端,文章卡片上的浏览量到底从哪来?这篇拆我自己这套链路:D1 里只有 pathname + views 两列、两个读接口的分工、前端如何一次批量取数并先藏后显避免抖动、列表页按热度排序的索引对齐,以及防刷与缓存口径的取舍。
- 静态博客接评论:Giscus 的配置、主题联动与三个坑静态博客没有后端,评论只能挂第三方。这篇记录 Giscus 的完整接入:六个配置字段各自的作用、用自定义 CSS 做暗色联动的原理、不靠肉眼验证评论是否真的加载的方法,以及仓库迁移、改 slug、iframe 布局跳动三个坑。