静态博客怎么显示每篇文章的浏览量:从 D1 读数接口到前端排序的完整链路
静态博客最难的不是写页面,是页面之外的数字:每篇文章有多少人看过、全站累计多少。这些数字不在文件系统里,也不在构建产物里——你得先有东西把它写进某个地方,再把它读回来。
我这套的分工是:访客画像交给 Umami Cloud 的官方脚本(有后台、有地域和设备维度),页面计数用自己写的一套接口(t.juluo.work + D1 里一张两列的表)——页面引 tracker.js 往 /send 报一次,卡片再把 /batch 读回来渲染。本文按数据流讲一遍:从那两列的表,到文章页 meta 行里的「N 次」,再到列表页点一下眼睛图标就按热度重排。代码都在这个仓库里,接口行为全部用本机 curl 和 Chrome 实测过。
提示两处后记,都是同一晚发生的事:写入端(
tracker.js)原本忘了接,见第一篇补记;数据源后来改成优先读 Umami、自建退成兜底,见第二篇补记。正文里过时的说法我都标了「改造前」。
提示前置:本站是 Astro 静态站,跑在 Cloudflare Worker 的静态资源模式上(没有
main、没有服务端逻辑,构建产物直接由边缘节点分发),域名blog.juluo.work;计数接口是另一个 Workercf-umami(源码在公开仓库juluowork/cf-umami),数据存在 D1 的pageviews表。展示侧的开关就两个字段,写在src/config.ts里:
// 文章/页面浏览量:自建统计服务(Cloudflare Worker + D1,部署在 t.juluo.work)
export const viewCounterConfig: ViewCounterConfig = {
	enable: true,
	endpoint: "https://t.juluo.work",
};
先看这套东西现在的样子
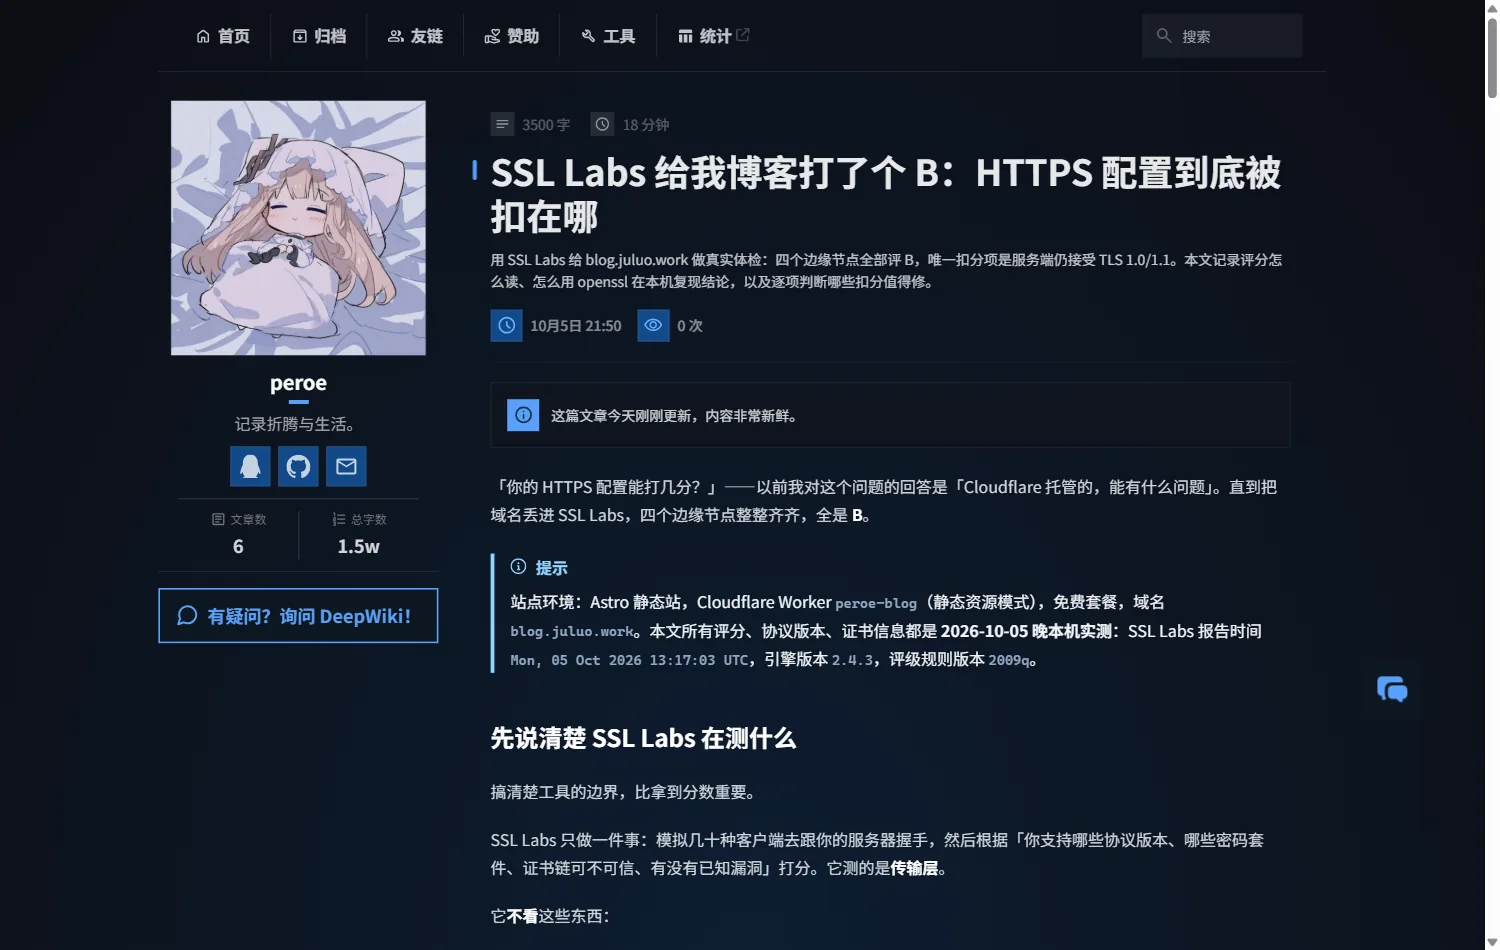
文章页的标题下面那行 meta:发布时间、浏览量图标加一个「0 次」。这个数字不是构建时写死的——看组件模板就知道(下面贴的是 PostMeta.astro 的源码,不是渲染后的 HTML),它渲染出来就是个空壳,slug 是文章 id:
<div class="flex items-center" id={`page-views-wrapper-${slug}`} style="display: none;">
    <div class="meta-icon">
        <Icon name="material-symbols:visibility-outline-rounded" class="text-xl"></Icon>
    </div>
    <span class="text-50 text-sm font-medium" id={`page-views-${slug}`}></span>
</div>
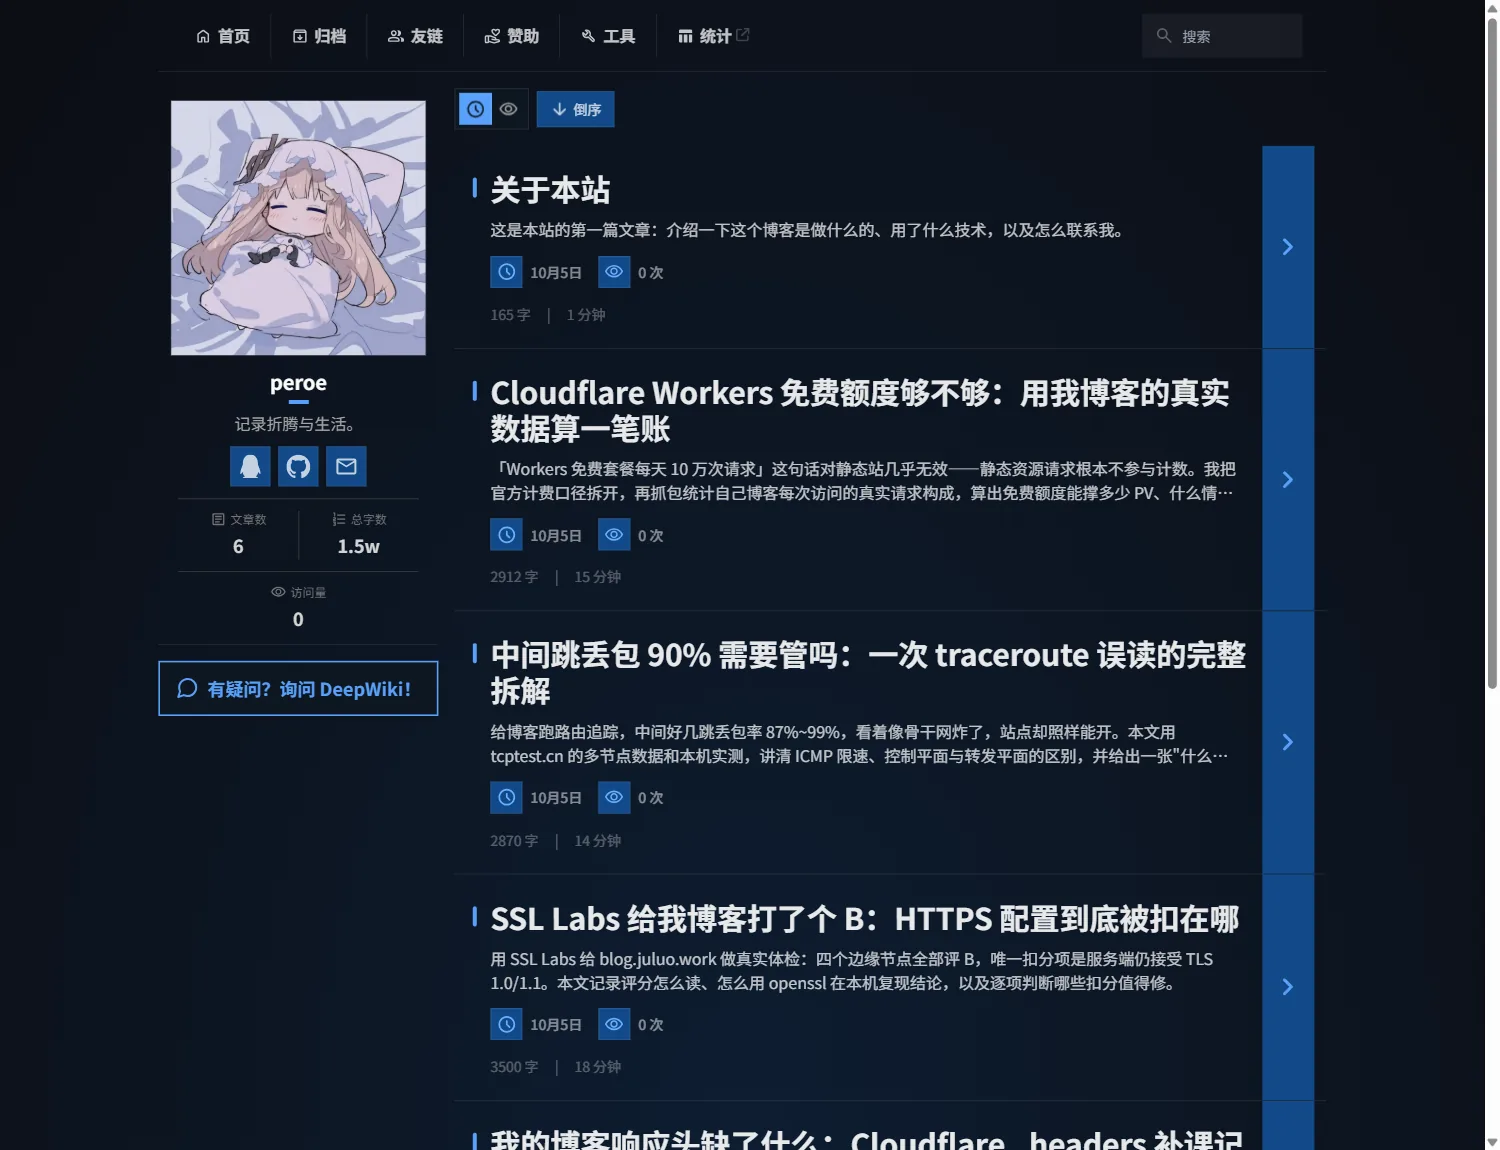
首页同样,每张卡片下挂着一个「0 次」,右上角多了排序控件。顺便注意侧栏:首页有「访问量 0」,文章页没有——这不是设计,是实现细节,放在「踩坑」里说(后来修掉了,见文末补记)。
真正值得在意的不是那一刻的 0,而是为什么会是 0:读数接口一路通着(下面有实测),却没有任何页面在往计数表里写。本文写作时(2026-10-05 晚)这套系统处于「只读不写」的状态,这个坑当天深夜补上了,改动集中在文末补记里;正文保留的代码与截图是当时的样子,我会在对应位置标出哪些已经变了。
为什么不用第三方统计的 API
最省事的做法是前端直接去第三方统计的分享页拉数字。我没选,理由都跟「展示」这个场景的特殊性有关:
- 分享页是给人看的页面,不是给浏览器 fetch 的接口。 它属于统计后台的一部分,渲染方式随时可能变,而文章卡片要长期依赖它的响应结构——绑得越紧越难拆。
- 跨域和配额都不在我手里。 读数请求要从
blog.juluo.work打到别人的域上,失败时我连「为什么失败」都看不到——是 CORS、是限流,还是接口改了。 - 展示只需要一个整数。 来源、设备、停留时长这些留在统计后台看就好,为了一个数字去拉一个通用分析接口,是拿大炮打蚊子。
自建的代价也很实在:多一个 Worker、多一张表、多一处要维护的东西。但它的失效模式是干净的:接口挂了,博客照常打开,只是数字不显示(我实测过,见后面的失败兜底)。
提示这段写于当晚 22 点,两个多小时后我自己把它推翻了:展示的数字改成优先读 Umami 的分享接口,自建那份退成兜底。三条理由本身没被推翻——变的是多了兜底,所以可以冒「接口随时会变」这个险。具体见文末「再补一刀」。
数据表:只有两列,是刻意的
D1 里的建表语句就一行(来自 cf-umami 仓库的 src/index.ts,我用 curl 核对过部署版本返回的错误字符串,行为与它一致):
CREATE TABLE IF NOT EXISTS pageviews (pathname TEXT PRIMARY KEY, views INTEGER NOT NULL);
写入也只有一句 UPSERT:
INSERT INTO pageviews(pathname, views) VALUES(?, 1) ON CONFLICT(pathname) DO UPDATE SET views = views + 1;
pathname 直接当主键,views 就是个整数计数。没有 IP、没有 UA、没有 session、没有时间戳。 这不是偷懒,是取舍:
- 好处:表小,查询就是一次主键查,不存任何可识别信息,连「匿名化」这一步都省了。
- 代价:UV、来源、停留时长、趋势曲线一概没有,这些交给 Umami。
另一个直接后果是路径必须规范化。同一个页面只要能通过两个 URL 打开,计数就会裂成两条。我的文章页只有 /posts/<slug>/ 一种形态,工具页统一用组件里写死的 pathname(比如 /tools/cover/ 这个页面,实际读写的路径是 /cover/——实测抓到的请求就是 GET /share?pathname=%2Fcover%2F),所以这件事暂时没炸。
接口契约:两个读接口,一个写接口
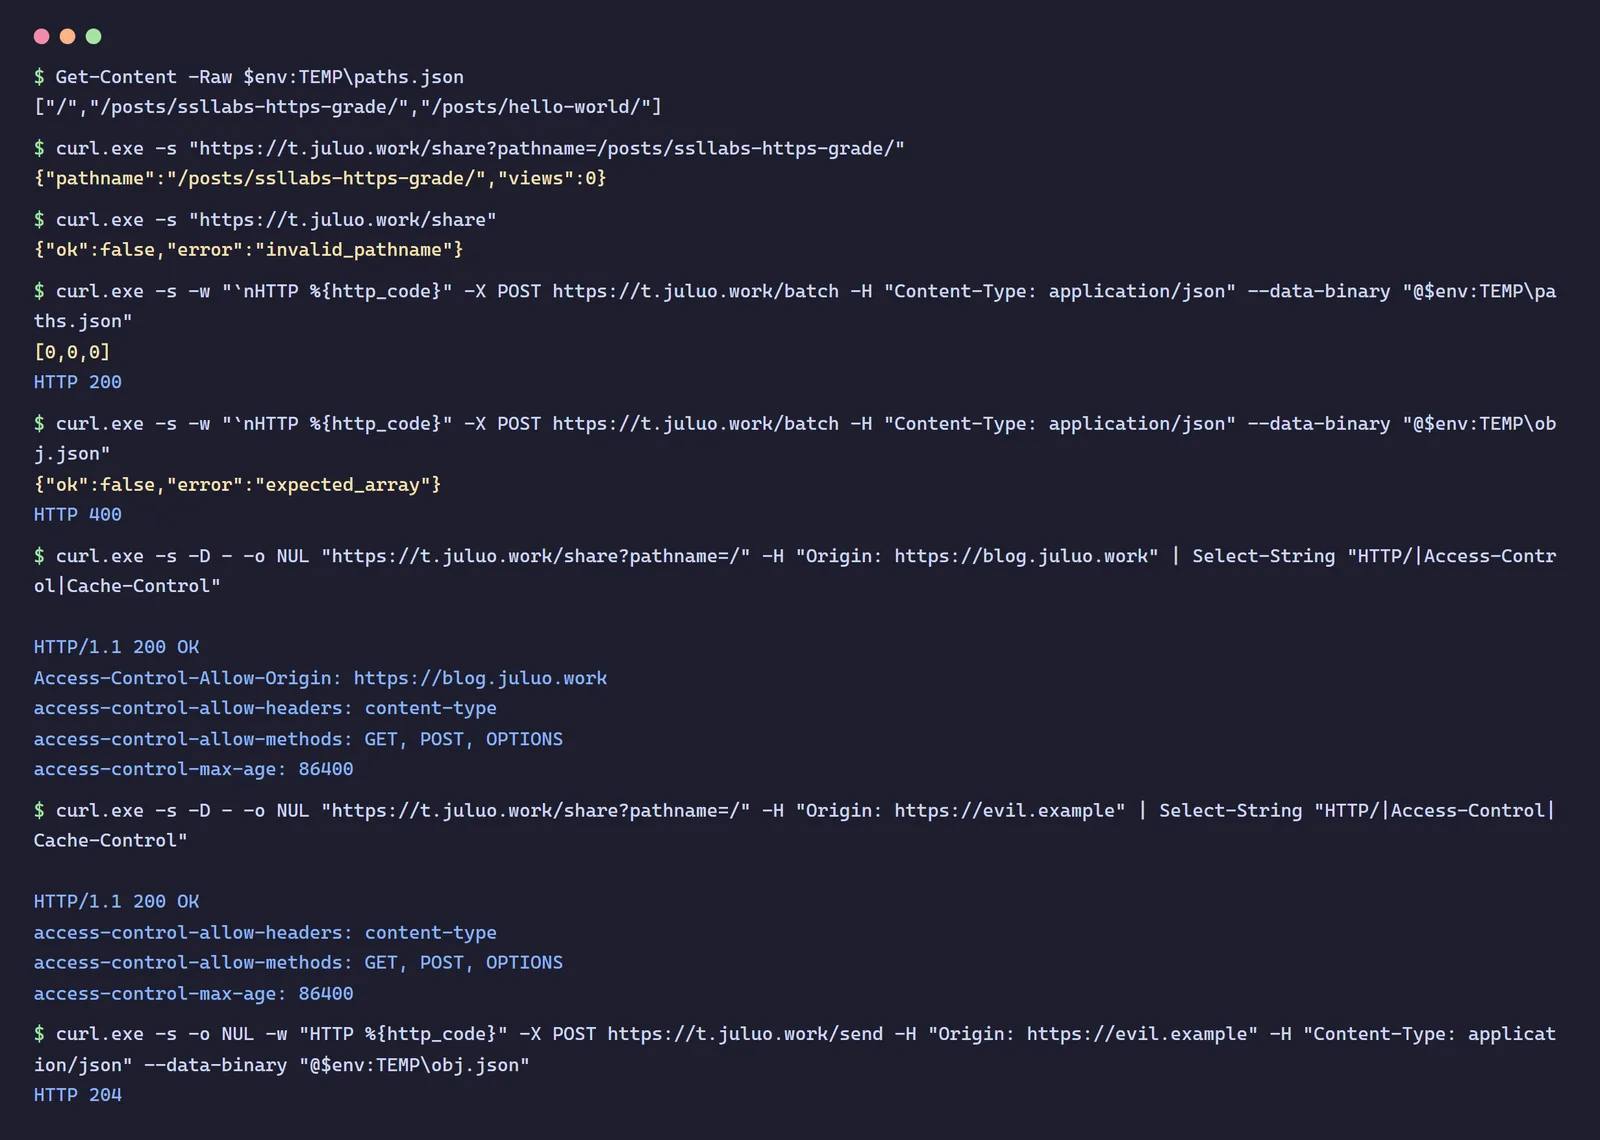
三个端点用 curl 跑一遍,下面是线上真实响应:
GET /share?pathname=/posts/xxx/→{"pathname":"/posts/xxx/","views":0},单个页面读数;参数缺失返回{"ok":false,"error":"invalid_pathname"}。POST /batch,请求体是裸 JSON 数组["/","/posts/xxx/"],返回同序数组[0,0];传对象进去会被拒:{"ok":false,"error":"expected_array"}(HTTP 400)。POST /send,单个写入,请求体是{"pathname":"/"},只接受来自本站 Origin/Referer 的请求,其他来源直接 HTTP 204 静默丢弃。
警告Windows PowerShell 会把命令行里内联 JSON 的双引号吃掉。
--data-raw '["/"]'实际只发出了 3 个字节,接口回{"ok":false,"error":"invalid_json"};把请求体写进文件、用--data-binary "@file"才能正常测通。我第一次测/batch就被它坑了,差点以为接口不认数组。
为什么读数用 POST 而不是 GET。 语义洁癖会说「读操作该用 GET」,但这套接口要一次读 N 个路径:GET 只能靠 ?pathname=a&pathname=b 或者逗号分隔,URL 长度、编码、去重规则全得自己定;POST + JSON 数组能把「顺序」表达得最清楚——顺序就是契约,讲排序时你会看到它有多关键。副作用是 POST 天然不可缓存,每次浏览都真的打一次查询,好处是数字永远新鲜。
前端:一次批量读,先藏后显
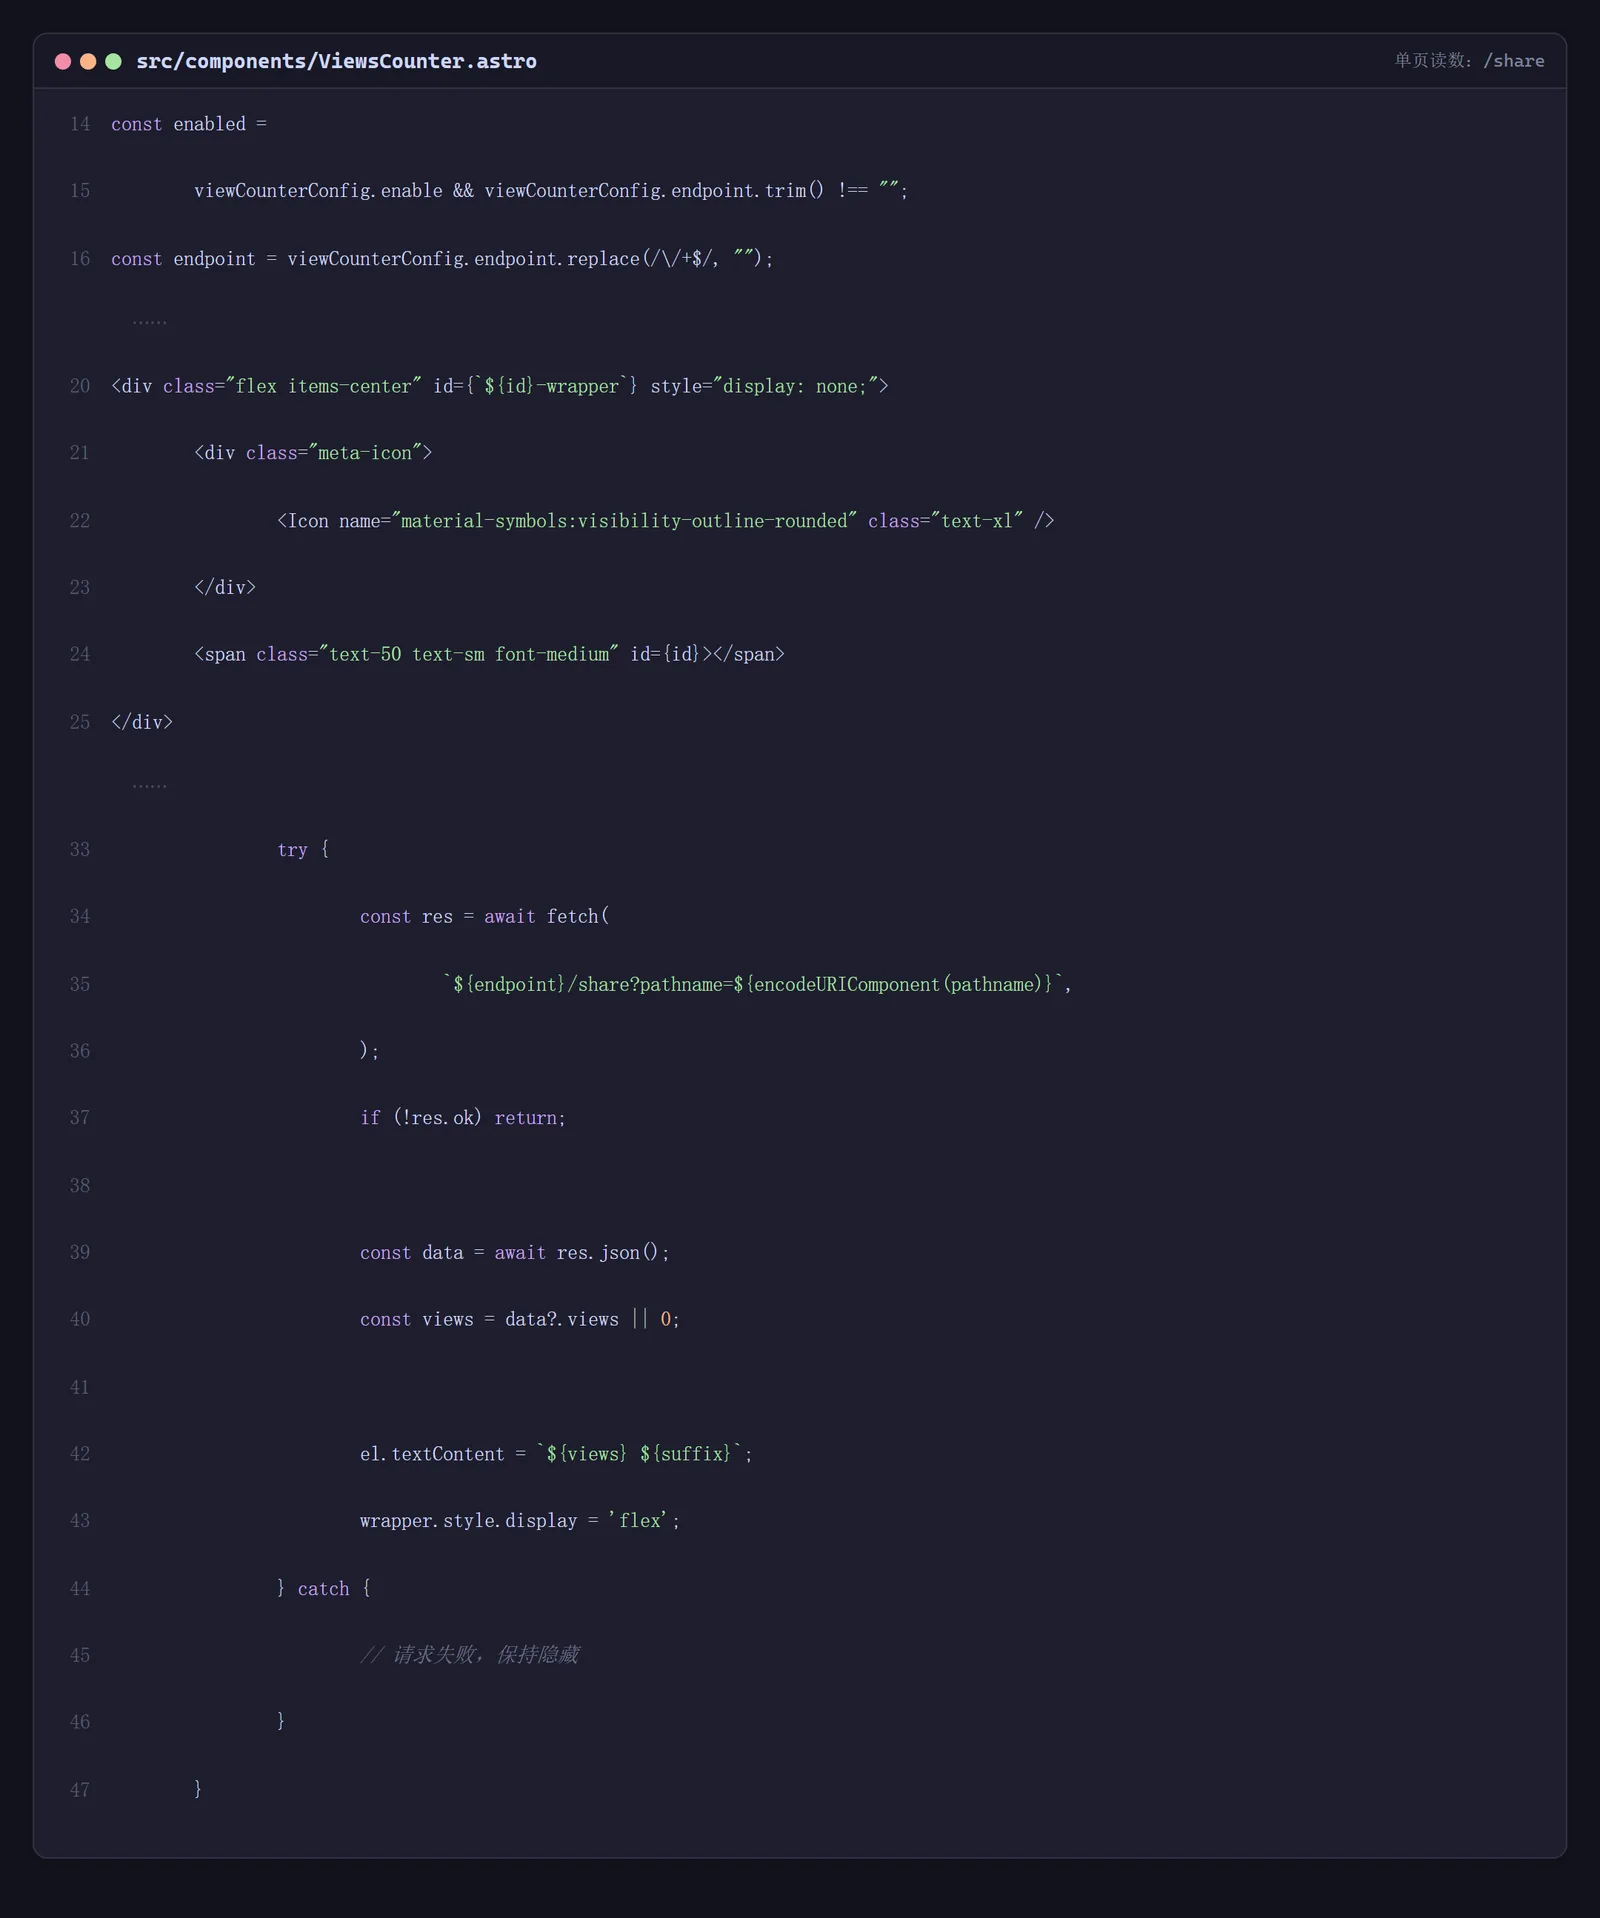
上图是单页读数组件 src/components/ViewsCounter.astro,用在工具页、课程表这类没有文章卡的页面上:/share 读一个路径、写进 span、把 wrapper 从 display: none 改成 flex。
关键在「藏」这个动作上。 组件渲染出来的 wrapper 带 style="display: none;",服务端渲染阶段它就是个不占位的空壳,数字是客户端拿到之后才亮的。如果先渲染一个「0 次」占位、等接口回来再换成「1234 次」,用户会看到数字跳变,数字宽度变化还会把整行 meta 往前推一下——比晚半秒出现难看得多。代价是这一行从无到有时,下面的内容会有一次小位移,但至少不会有错误的数字被看到。
实测:工具页整页只发出 1 个请求 GET /share?pathname=%2Fcover%2F,然后 span 里出现「0 次」。
文章页和列表页走的是另一条路——批量读。一页最多 8 张卡片(src/constants/constants.ts 里的 PAGE_SIZE = 8),每张各发一个 /share 就是 8 个请求,既慢又费额度。所以这里的机制是「先登记、再一次性取数」——不是并发发起 N 个请求,而是把 N 个路径压进同一个请求:
登记这一步做在卡片组件里(src/components/PostMeta.astro 的内联脚本,页面上有几张卡片就有几份):
window.__VIEWS_QUEUE__ = window.__VIEWS_QUEUE__ || [];
if (!window.__VIEWS_QUEUE__.includes(slug)) {
    window.__VIEWS_QUEUE__.push(slug);
}
真正发请求的是独立的读取端 src/scripts/view-counter-runtime.ts(挂在 Layout.astro 上,所以每个页面都有,而且每页只跑一次):
const slugs = collectSlugs(); // 列表页读 __PAGE_POSTS_DATA__,其它页面读 __VIEWS_QUEUE__
const pathnames = ["/", ...slugs.map((slug) => `/posts/${slug}/`)];
const res = await fetch(`${endpoint}/batch`, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify(pathnames),
});
请求体永远以 / 打头,所以不管在哪一页,侧栏那个全站访问量都能顺带取回来。抓包实测:线上首页是 9 条路径(/ 加 8 篇文章),发往 t.juluo.work 的请求只有 1 条——POST /batch。代价也在这句话里:只要其中任意一个 pathname 不合法,整个 /batch 就返回 400(实测:数组里混进一个不以 / 开头的路径,整批请求直接失败),那一页的数字会全部不显示——「全对才给」的严格口径,换来的是前端永远不用处理”部分成功”。
提示「9 条路径」只是那一刻的快照,别当成固定值:请求体长度永远等于线上文章数 + 1(多出来的
/是侧栏那个全站访问量)。文章数一变,这个数字就跟着变。
列表页按热度排序:索引对齐才是真难点
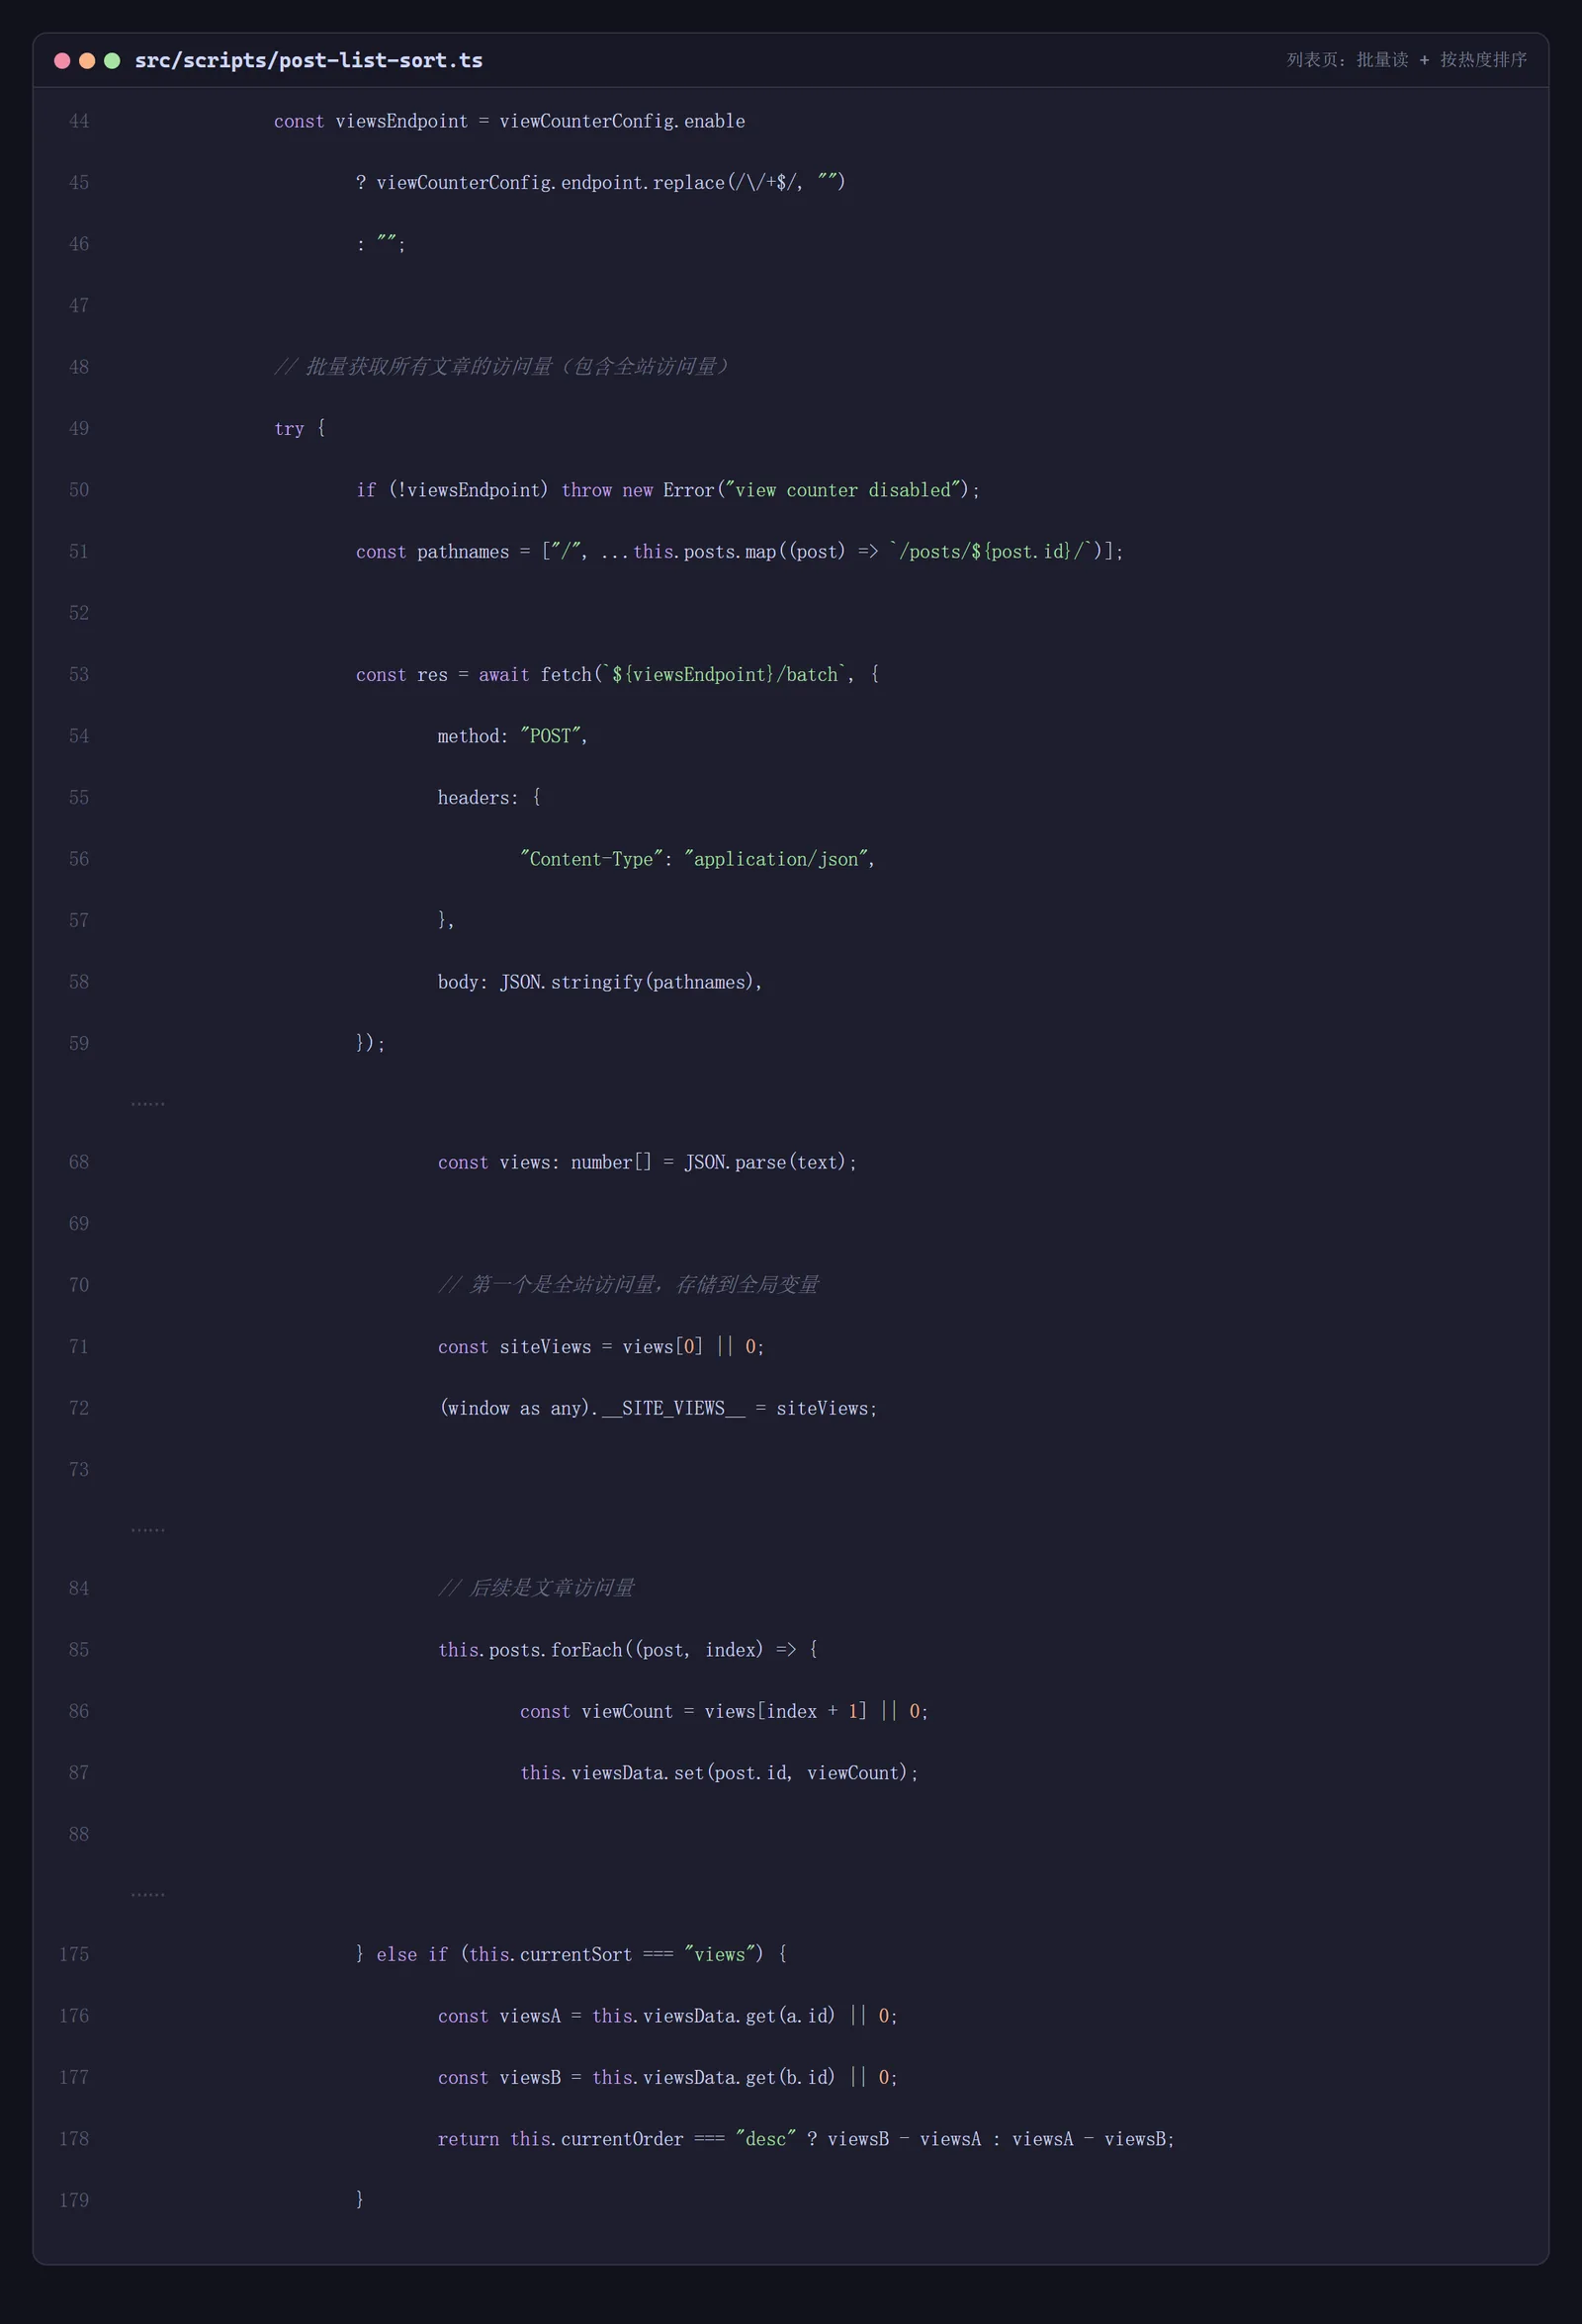
列表页的排序完全在客户端做(src/scripts/post-list-sort.ts)。文章数据在构建时就被塞进页面:
window.__PAGE_POSTS_DATA__ = pagePostsData;
这段在 src/pages/[...page].astro 里,pagePostsData 是 id / title / published / pinned 四个字段的精简对象。排序脚本拿到它之后一次读完,再靠下标把数字分回去:
views[0]是全站访问量,写进侧栏的#site-views——这一步由读取端直接做,排序脚本不掺和;views[index + 1]才是第index篇文章的量,填进卡片上那个 span,同时通过post-views-loaded事件广播出去,排序脚本收到后存进viewsData这个 Map。
排序在 getSortedIndices() 里:日期模式按 published 排(置顶优先),访问量模式按 Map 里的数字排;render() 不做 diff,直接把 article 元素按新顺序 appendChild 回容器——元素复用,只是顺序变了。
这套实现的脆弱点恰恰是它的简洁:请求数组、响应数组、__PAGE_POSTS_DATA__ 三个顺序必须完全一致。任何一边多一个、少一个、乱一个,数字就会串到别的文章上,而且不会报错,你只会觉得数字”有点怪”。换成对象数组([{pathname, views}])当然更稳,但接口契约已经定了,眼下改它的收益不值这个工。
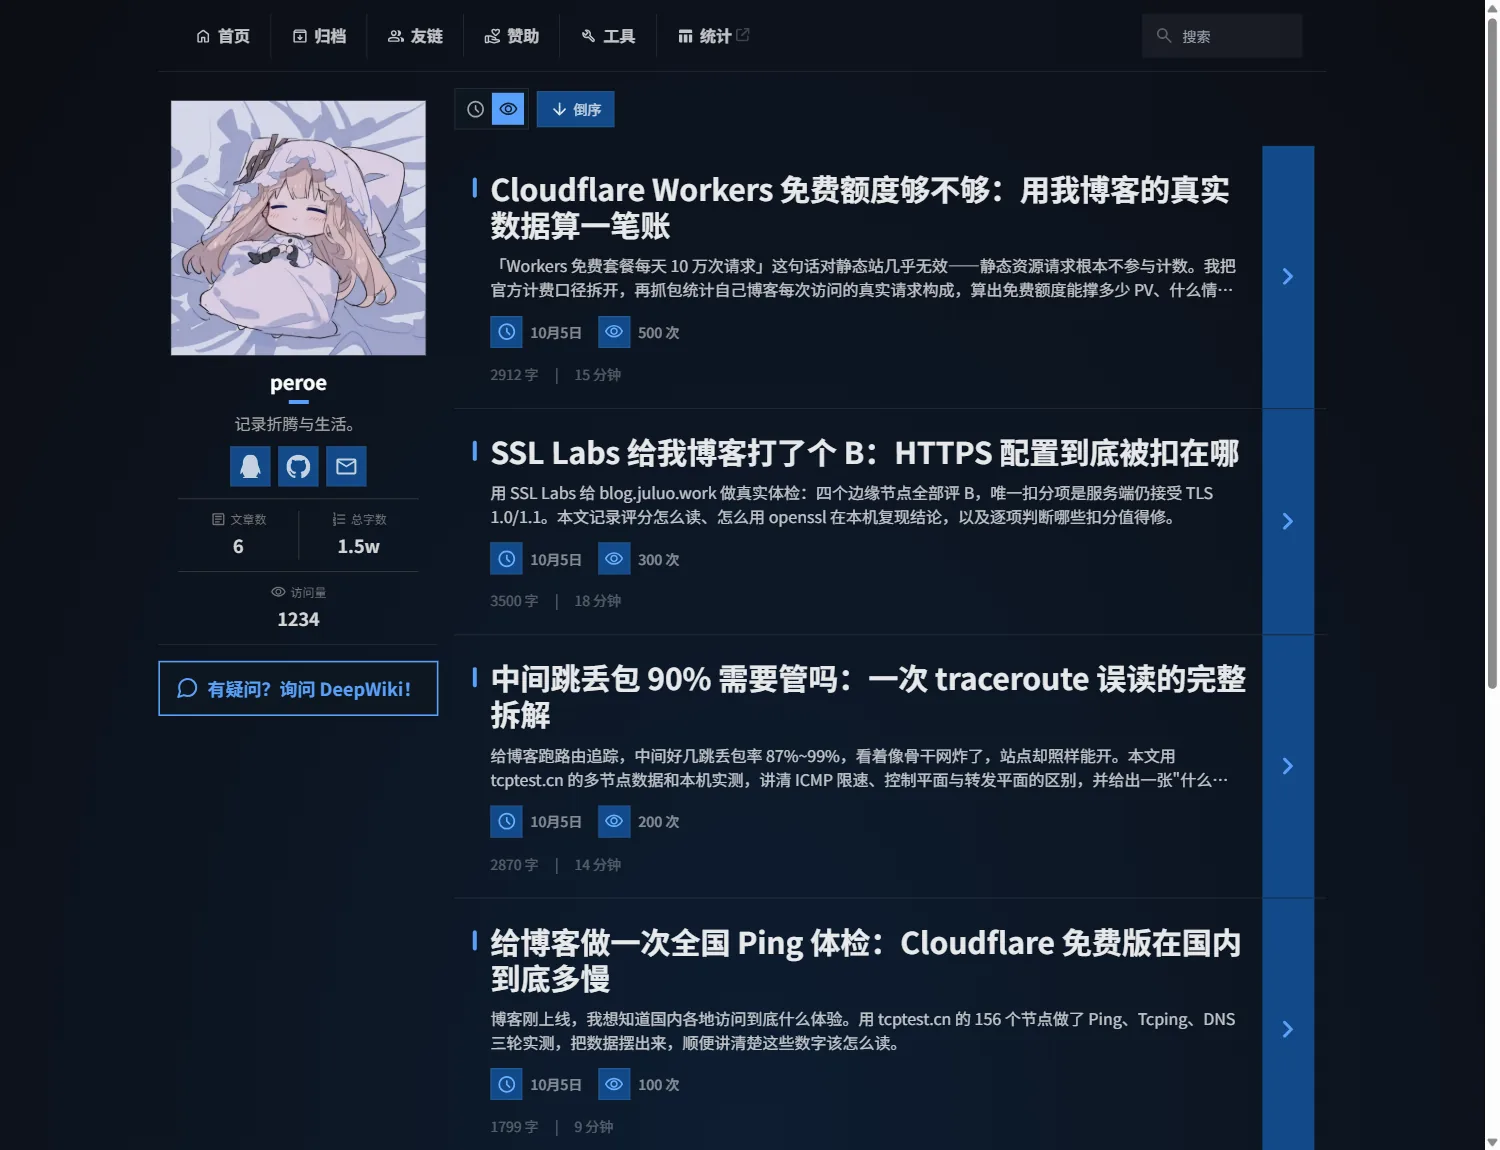
这里有个尴尬的现实:写作当时线上所有计数都是 0,点「按访问量排序」看不出任何变化——每个比较都返回 0,而 V8 的 sort 是稳定的,顺序原样保留(只有按钮的 active 样式变了)。为了验证逻辑本身,我把 /batch 的响应体在浏览器里换成了模拟数据(页面代码一行没改,也没有往 D1 写任何东西):
- 6 张卡片(就是当时首页那几张)按模拟计数从大到小重排:500 / 300 / 200 / 100 / 50 / 10,侧栏全站数变成 1234;
- 再点一次顺序按钮(「倒序」→「正序」),顺序整个反过来:10 / 50 / 100 / 200 / 300 / 500。
也就是说批量取数、下标映射、排序三件事都是通的。唯一没验证的是真实非零数据——那需要有人往表里写,而这正是当时缺的那一环;接入上报之后我用真实数据又跑了一遍,见文末补记。
防刷与缓存口径
防刷。 先说清楚:这套守卫不是防刷,是防误写。
- 读接口(
/share、/batch)完全公开,任何人 curl 都能拿到数字。它只做了 CORS 白名单:带外域 Origin 请求时响应里根本没有Access-Control-Allow-Origin(实测),浏览器会拦掉读取——但这拦不住 curl。 - 写接口
/send会检查 Origin/Referer 的 host 是否等于配置的目标站点,不等就 204 静默丢弃。我拿一个没人访问的路径试过:带外域 Origin 时返回 204,随后用/share查该路径仍然是views: 0,说明它确实没写进去。它拦的是「别的站把上报误打过来」,同样拦不住伪造 Origin 的脚本。 - 真要防刷得靠边缘的 WAF / 限速规则。而我这里是读接口被刷,代价只是 D1 的行读,真正要担心的是有人拿它刷用量,不是数据被篡改。
缓存。 实测两个读接口的响应头里都没有 Cache-Control(我用 Select-String 过滤响应头,一条都过滤不出来),而 POST 本身也不可缓存。所以每次浏览都会实打实打一次查询:数字永远新鲜,也意味着没有「缓存穿透」这类问题需要额外机制去补。
顺带一个反面样本:上报脚本 /tracker.js 是有缓存的(Cache-Control: public, max-age=3600),而它当时在页面上一次都没被引用——我 curl 了首页、文章页、归档、友链、赞助、隐私、工具几个页面,tracker.js 出现次数都是 0。所以那会儿的状态是:读接口跑得很勤,写接口准备好了但没人调用。写接口接上去之后,缓存反而是好事:脚本每页只下载一次的量级,被浏览器缓存住就不会反复消耗请求额度。
踩坑与注意事项
- 文章页看不到侧栏的「全站访问量」,首页能看到。 因为全站数字是排序脚本顺带取回来的(
views[0]),而排序脚本只在列表页加载;文章页只有 PostMeta,它只取自己那一条。实测:首页#site-views-wrapper的display是grid,文章页是none。同一个侧栏组件,两个页面表现不一致。(已修:读取端统一后,任何页面都会把/带上,见补记。) - 0 数据下的排序”看起来失效”。 点按钮时
active样式会变(说明事件绑上了),但顺序纹丝不动,因为比较器对所有组合都返回 0。测排序逻辑不能只看线上表现,得先把数据换成非零的。 - 接口挂了要能安静地不显示。 我把
/batch分别换成 500 和「200 + 空响应体」测了一遍:列表页、文章页都不显示任何数字,页面其他部分完全正常,控制台的pageerror里也没有浏览量相关的报错。空响应体当时靠一句throw new Error('Empty response')拦下,统一读取端之后换成了Array.isArray(views)检查。这个「宁可不显示,也不显示错的」兜底是免费的——因为渲染前就检查了res.ok。 /batch是 N 次串行查询。 Worker 源码里就是一个for循环,每个 pathname 单独SELECT一次,没有用IN一次查回来;而且每次请求进来还会先跑一遍CREATE TABLE IF NOT EXISTS。写作时首页那 7 个路径就是 7 次串行查询。现在文章少看不出差别,等文章上百篇,这就是最该先改的一处(一次IN查询 + 把建表检查挪出热路径)。- 与本文无关但顺手发现的一个报错:线上页面控制台里一直有
cookieConsentConfig is not defined(Cookie 同意横幅那个脚本)。它不影响浏览量,但它说明客户端脚本的错误最容易长期潜伏——因为很少有人天天开着控制台看自己的博客。
收尾:给想抄这套的人一份清单
判断先放在前面:静态博客要显示浏览量,下限方案是「一个只读接口 + 一次批量读 + 服务端渲染留空位」,而不是去引第三方统计的公开接口。 展示和统计是两件事,混在一起做,哪天统计服务改个接口,你就得跟着改文章卡片。
但更值得记住的是这条:显示链路和写入链路是两件独立的事。 我这套当时读得又快又稳,数字却全是 0——因为没有页面上报。它不是读数接口的毛病,是「先把读的那半截跑通、写的那半截还没接」的状态;接上 tracker.js 会让每次 PV 多 1 个请求额度(这笔账在上一篇里算过),所以我先留着了——留到当天深夜,看着满屏 0 实在难受,还是接了,过程见下面的补记。所以:如果你在自己站点上看到每篇都是 0 次,先别怀疑接口,去抓一次包看有没有 /send。
要抄的话,按这个顺序做:
- 定一张两列的表(
pathname主键 +views计数),别急着存 UA/IP——那些需求九成不会实现,真要实现也该换一套表。 - 接口分三个:单读(
/share)、批量读(/batch,请求体就用裸数组,顺序即契约)、写(/send,带 Origin 守卫并按需静默丢弃)。 - 前端先渲染空壳(
display: none),拿到数据再亮——不要先渲染 0 再跳数。 - 一页上多个组件要读数时,用「队列登记 + 一个统一读取端」,别让每个组件各自发请求,也别让「只有某个页面才取得到某个数字」。
- 依赖下标的排序逻辑,一定要用非零的模拟数据测一遍,别拿线上的全 0 当”测过了”。
- 失败路径要测全:500、空响应体、CORS 被拦,三种情况下页面都应该安静地不显示数字。
- 读和写都要验:读接口返回 0 不等于”接口坏了”,先 curl 一次写接口,确认是「写不进去」还是「没人写」。
补记(2026-10-05 深夜):把写入端接上,顺手统一了读取端
上面这篇发出不到两小时,我就把「只读不写」这半截补上了——满屏的 0 摆在首页上,比多花一个请求额度难受得多。动手之后才发现问题不止一个。
现象与定位
先用 curl 把两半截分开验:
# 读:接口活着,只是表里没数据
curl -s "https://t.juluo.work/share?pathname=/posts/hello-world/"
# {"pathname":"/posts/hello-world/","views":0}

# 写:拿本站 Origin 手动打一次,立刻就进去了
curl -s -X POST "https://t.juluo.work/send" \
  -H "content-type: application/json" -H "Origin: https://blog.juluo.work" \
  -d '{"pathname":"/__selftest"}'
# {"ok":true}
curl -s "https://t.juluo.work/share?pathname=/__selftest"
# {"pathname":"/__selftest","views":1}
服务端两半截都是好的,缺的是「让浏览器去调它」。 Chrome 抓包也印证了这一点:每个页面只发出 1 条 POST /batch(读),/send 一条都没有。
警告
pathname是我自己写的测试路径,它会永久留在 D1 里(这张表只增不减)。清理命令是npx wrangler d1 execute cf-umami --remote --command "DELETE FROM pageviews WHERE pathname LIKE '/__selftest%'" -y,需要 Cloudflare 登录态。
改动一:把 tracker.js 引进页面
src/components/layout/BodyThirdPartyScripts.astro 里加一行,跟着 viewCounterConfig 走:
{viewCounterConfig.enable && viewCounterConfig.endpoint.trim() !== "" && (
	<script is:inline defer src={`${viewCounterConfig.endpoint.replace(/\/+$/, "")}/tracker.js`}></script>
)}
tracker.js 自己会用 document.currentScript.src 推出 t.juluo.work,再按 location.pathname 报一次,不需要额外参数。实测现在每次页面浏览固定 3 个请求:GET /tracker.js(可缓存 1 小时)、POST /send、POST /batch。
提示下面两小节(改动二、实测)写的是第一版:读取端只问自建接口。同一夜更晚的那次改造把数据源换成了「优先 Umami、自建兜底」,读取端结构没变,但请求数从 3 条变成了
tracker.js + /send + (1 + N) 条 Umami 查询,细节见文末「再补一刀」。
改动二:读取端收拢成一个脚本
原来取数逻辑散在两处(PostMeta.astro 的内联脚本 + src/scripts/post-list-sort.ts),靠 __VIEWS_FETCHED__ 和 __PAGE_POSTS_DATA__ 两个全局标志互相让位。能用,但有个硬伤:/ 这个路径只有排序脚本会拼进去,而排序脚本只挂在列表页——所以文章页、归档页的侧栏「访问量」永远是隐藏的,同一个组件在不同页面表现不一致。
现在收拢成 src/scripts/view-counter-runtime.ts:卡片只往 __VIEWS_QUEUE__ 里登记 slug,读取端每页跑一次、请求体固定以 / 开头;回来之后 views[0] 写侧栏,其余按 slug 填卡片,最后广播一个 post-views-loaded 事件给排序脚本消费。排序脚本里那段 fetch 和「数据没到就 setInterval 轮询」的代码也一起删了,它现在只管排序。(__VIEWS_FETCHED__ 这个标志当天夜里也一并删掉了——收拢之后没有任何地方读它,留着就是死代码。)
实测(本机构建 + Chrome 抓包,第一版:读取只走自建接口)
| 页面 | 发往 t.juluo.work 的请求 | 侧栏 #site-views |
|---|---|---|
首页 / | /tracker.js、/send {"pathname":"/"}、/batch ["/", 8 篇文章] | 显示 |
文章页 /posts/xxx/ | /tracker.js、/send {"pathname":"/posts/xxx/"}、/batch ["/", "/posts/xxx/"] | 显示(改造前是 display: none) |
归档页 /archive/ | /tracker.js、/send {"pathname":"/archive/"}、/batch ["/"] | 显示(改造前连请求都没有) |
上报用的 pathname 和读接口用的 key 完全一致,都取自带尾斜杠的 location.pathname——这点值得特意确认一次:不带斜杠的 /posts/hello-world 会被静态资源 307 跳到带斜杠的地址,浏览器里最终就是带斜杠的形态,两边天然对齐。
再把 /batch 的响应体换成非零数据跑一遍排序:8 张卡片按 85 / 78 / 78 / 78 / 72 / 36 / 16 / 2 从大到小重排,再点一次顺序按钮整个反过来,和前面用模拟数据得到的结论一致。
遗留
- 侧栏那个「访问量」是首页
/的 PV,不是全站所有路径求和。 想要真·全站合计,得给 Worker 加一个SUM(views)的接口——那是另一个仓库,这套前端改不动它。(这条下一节就绕过去了:改用 Umami 之后,全站数字直接读它的总 PV。) /batch仍是 N 次串行查询(踩坑 4),文章上百篇之前得先改成一次IN查询。- 踩坑 5 那个
cookieConsentConfig is not defined还在:它跟浏览量无关,但确实说明客户端报错最容易长期潜伏——毕竟没人天天开着自己的控制台。
再补一刀(同一夜更晚):数据源改成「优先 Umami,自建退成兜底」
上面那套修完,数字确实是真的了,但全是从零开始的真:D1 里第一行数据诞生于今晚,而 Umami 从 2025 年 8 月就在记这个站。读者点开一篇文章看到「1 次」,不会觉得「这站刚上线」,只会觉得坏了。
所以数据源换了个顺序:先读 Umami,读不到再用自建的 D1 补。
先说清楚:这篇前面写过「不用第三方统计的 API」
第三节我列了三条理由不用它。现在等于自己打脸,所以把话说透——这次能用,是因为兜底还在:
- 我用的不是统计后台的通用分析接口,而是分享页自己在用的那两个只读接口,拿回来的就是两个整数(
pageviews),没有来源、设备、地区这些维度; - shareId 本来就是公开的(导航栏「统计」直接指向分享页),不需要任何密钥、不泄露账号;
- 最关键的一条:它随时可能变。这是无文档的内部接口,参数是我照着分享页抓包 + 对着 umami 源码对出来的。所以 D1 那条链路一行不删,
tracker.js继续上报——Umami 挂了,数字照常显示,只是换成自建那份。
怎么读:一条分享 token + 两个请求头
GET  {gateway}/api/share/{shareId}                      -> {"websiteId":"842d…","token":"<JWT>"}
GET  {gateway}/api/websites/{websiteId}/stats?startAt=0&endAt=<毫秒>          -> 全站全时段 PV
GET  {gateway}/api/websites/{websiteId}/stats?…&path=eq.%2Fposts%2Fxxx%2F     -> 该路径全时段 PV
     header: x-umami-share-token: <token>      # 10 分钟有效
     header: x-umami-share-context: <shareId>  # 少这个一律 401
两个坑都是抓包抓出来的:
- 少了
x-umami-share-context就是 401。 我一开始只带了 token,怎么调都是{"error":{"message":"Unauthorized"}},换成浏览器里发也一样。翻 umami 源码才看到那段判断:拿到了 share token 还要检查分享上下文头,否则打日志Share token used outside share context直接拒掉——它防的是把别处签发的 token 拿来读分析数据。 - 网关是分区的。 后台在
cloud.umami.is/analytics/us/,数据接口却在gateway-us.umami.is。换区部署的话这个域名要跟着换,src/config.ts里的umamiConfig.shareApiBase就是给它留的。 - 网关填错不会报错,只会静默全 0。 这条是事后审计时才补测的:同一个 shareId,
gateway-us和gateway-eu都能换到 token(这个接口跨区),但数据只认网站所在的区——查到别的区返回的是 HTTP 200 + 全 0,不是错误码。而0在前端眼里是合法数字,所以它不会触发兜底,页面就安安静静显示 0。换区时务必打开自己的分享页、在 Network 里核对域名,别凭记忆填。
代码怎么改的:一个读取端,两个数据源,按缺口回落
src/scripts/view-counter-runtime.ts 现在做三件事:
- 收集本页要显示的路径(文章 slug +
ViewsCounter登记的任意路径,比如/cover/); - 并发问 Umami:全站 1 条、每个路径 1 条;token 缓存在
sessionStorage(8 分钟),401 时丢掉重取一次; - 只把 Umami 没给到数字的那些路径,凑成一个数组发给自建
POST /batch补齐。
合并时是 {...自建, ...Umami}——Umami 优先,自建只填缺口,不做加法。两边数的是同一批访问,加起来就重复了;这也意味着 D1 里那条从零开始的曲线不会污染 Umami 的历史数字。
顺便把侧栏的体感调了一下:全站那一次请求单独接出来先画,不用等最慢的那篇文章。
实测(本机构建 + Chrome 抓包,全是线上真数据)
| 场景 | 结果 |
|---|---|
| 首页 | 侧栏 2229(Umami 全时段 PV,+2.2s 出现);8 张卡片 +3.5s 全部亮起:12 / 12 / 7 / 1 / 1 / 1 / 0 / 0 |
| 文章页 | 侧栏 2229 + 该文 PV,只有 2 条 Umami 请求(全站 + 本篇) |
掐断 gateway-us.umami.is | 自动回落到 POST /batch ["/", "/posts/…"],栏目照常显示(我用 111 的假数据肉眼确认回落生效) |
| 强制所有 stats 返回 401 | 换 token 重试一次仍失败 → 回落自建接口,页面无报错、数字不跳 0 |
有一处得说清楚:Umami 那个站是 2025-08 建的,路径表里还留着 /peroe、/posts/fullstack-ssr 这类旧站路径,所以全站 2200+ 里有一部分不是现在这个站的访问。介意的话在 Umami 后台重置统计数据,或者把侧栏改成只认某段时间。
更新后的遗留
- 每页要打 N+1 个请求给 Umami(首页 9 条:全站 1 + 8 篇),比自建那一次
/batch重;换来的是「数字和 Umami 后台对得上」。要降请求数,可以换成一条metrics?type=path&limit=100拿全部路径——但那个口径是**访客数(UV)**不是浏览量(PV),和卡片上的「N 次」对不上,所以我没选。 - 数字出得慢一点:Umami 这边冷启动约 2~4 秒才亮全(自建是 200 毫秒级)。数字是「先藏后显」的,所以代价只是晚一点出现,不会先给个错的。
- 自建那份现在只剩兜底价值,但必须留着:
tracker.js继续上报,Umami 一变脸它立刻顶上。 - 踩坑 5 那个
cookieConsentConfig is not defined依然在。
发现错误或想要改进这篇文章?
在 GitHub 上编辑此页文章修订历史 (1 次)
查看变更记录
docs(baseline): 第 30 轮终检——数字更新到最终状态,补第 28~30 轮小结
相关文章
- 同一个站的两套统计,为什么差了 2.7 倍本站装着两套统计:Umami Cloud 与自建的 Worker + D1。同一时间窗内,首页一个记 67 次、一个记 180 次。我做了个实验证明主因是广告拦截器,并列出另外三种会放大差距的机制,以及最后决定给读者看哪个数字。
- 静态博客的站内搜索是怎么做的:一份 JSON 索引加自己写的打分静态站没有后端,站内搜索只能在前端想办法。这篇拆开本站实现:构建期把 Markdown 压成一份 51 KB 的 search.json,浏览器整份拉下来逐字段数命中次数,再按日期排序。附实测的索引体积构成、逐字输入的重取代价与踩过的坑。
- 静态站的标签体系:挖出 11 个可收录页面23 篇文章、20 个标签,但页面上一个标签都看不到——前端组件把 tags 静默忽略了。这篇记录怎么把标签变成 11 个可收录页面(10 个标签落地页 + 索引),以及中文标签在 Astro 里踩到的三个坑。