静态博客的站内搜索是怎么做的:一份 JSON 索引加自己写的打分
静态站没有后端,站内搜索这种「看起来必须有服务端」的功能就得换个思路。本站的办法很土:构建期把每篇文章压成纯文本塞进一份 search.json,打开搜索框时浏览器把整份索引拉下来,在本地逐字段数命中次数,再按日期排序。
这份索引现在 51,653 字节、6 条记录,最大的一条 14 KB。文章少的时候它很划算——零后端、零外部服务、零依赖;但代价也是真的:每敲一个字,整份索引重新下载一遍。这篇把这条链路拆开,讲清楚它为什么这么写、代价具体是多少。
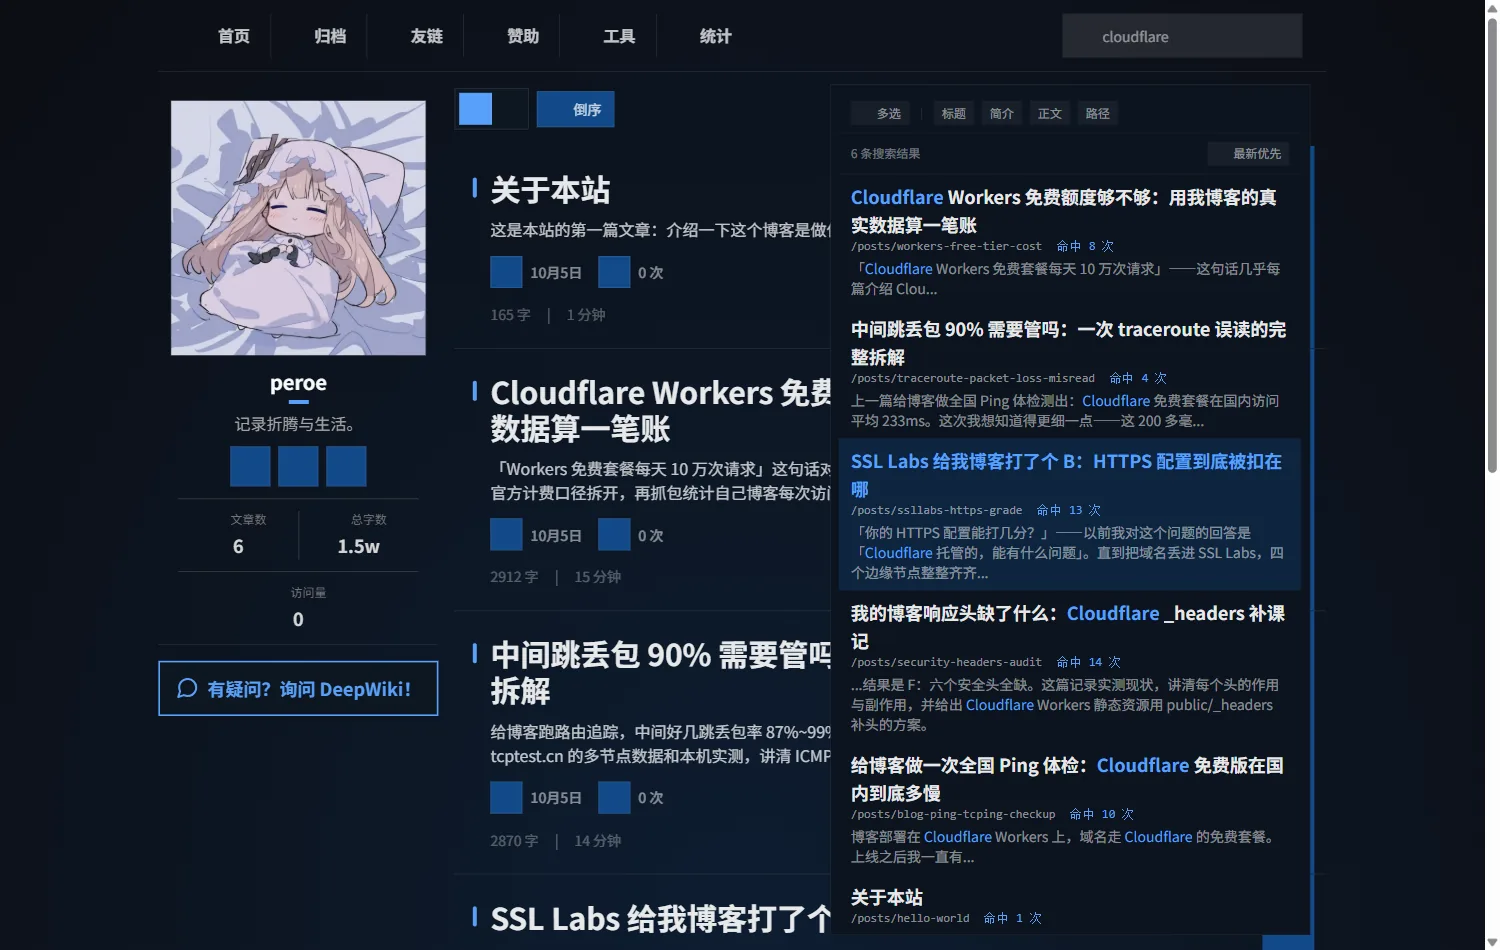
提示前提:本站是 Astro 静态输出 + Svelte 组件岛,跑在 Cloudflare Workers 的静态资源模式上——没有服务端逻辑,也没有可写的数据库,所以「搜索」只能发生在浏览器里。 下面的数字都是 2026-10-05 在 https://blog.juluo.work 上实测的,当时线上索引收录 6 篇文章。
先比较三条路
站内搜索常见三种做法,我挨个想过:
| 方案 | 为什么没用 |
|---|---|
| Algolia / 各类托管搜索 | 要注册服务、拿 API Key、写前端 SDK,还要担心免费额度和数据出境。为了 6 篇文章不值得 |
| Pagefind | 构建期切片索引、运行时按需拉分片,是这类需求的正统解法;但本站文章总量还没到「一次全量下载会疼」的量级,引入它的配置成本大于收益 |
| 自己烘一份 JSON | 构建期生成、前端全量加载、自己写匹配。没有任何外部依赖,索引随时可 curl 出来看一眼 |
我选了第三条。判断依据是一个很粗糙的估算:现在 6 篇文章的索引是 51,653 字节,平均一篇约 8.6 KB。按这个斜率,100 篇文章的索引约 860 KB,gzip 之后约 390 KB——到那个量级就必须换方案,但在 20 篇以内,全量索引的体验反而比按需加载更好(没有分片加载的延迟、没有索引构建服务)。
索引是构建期烘出来的
生成逻辑只有一个文件,32 行,src/pages/search.json.ts。Astro 会把这类 API 路由在构建时执行一次,把返回的 Response 落成静态文件 dist/search.json。
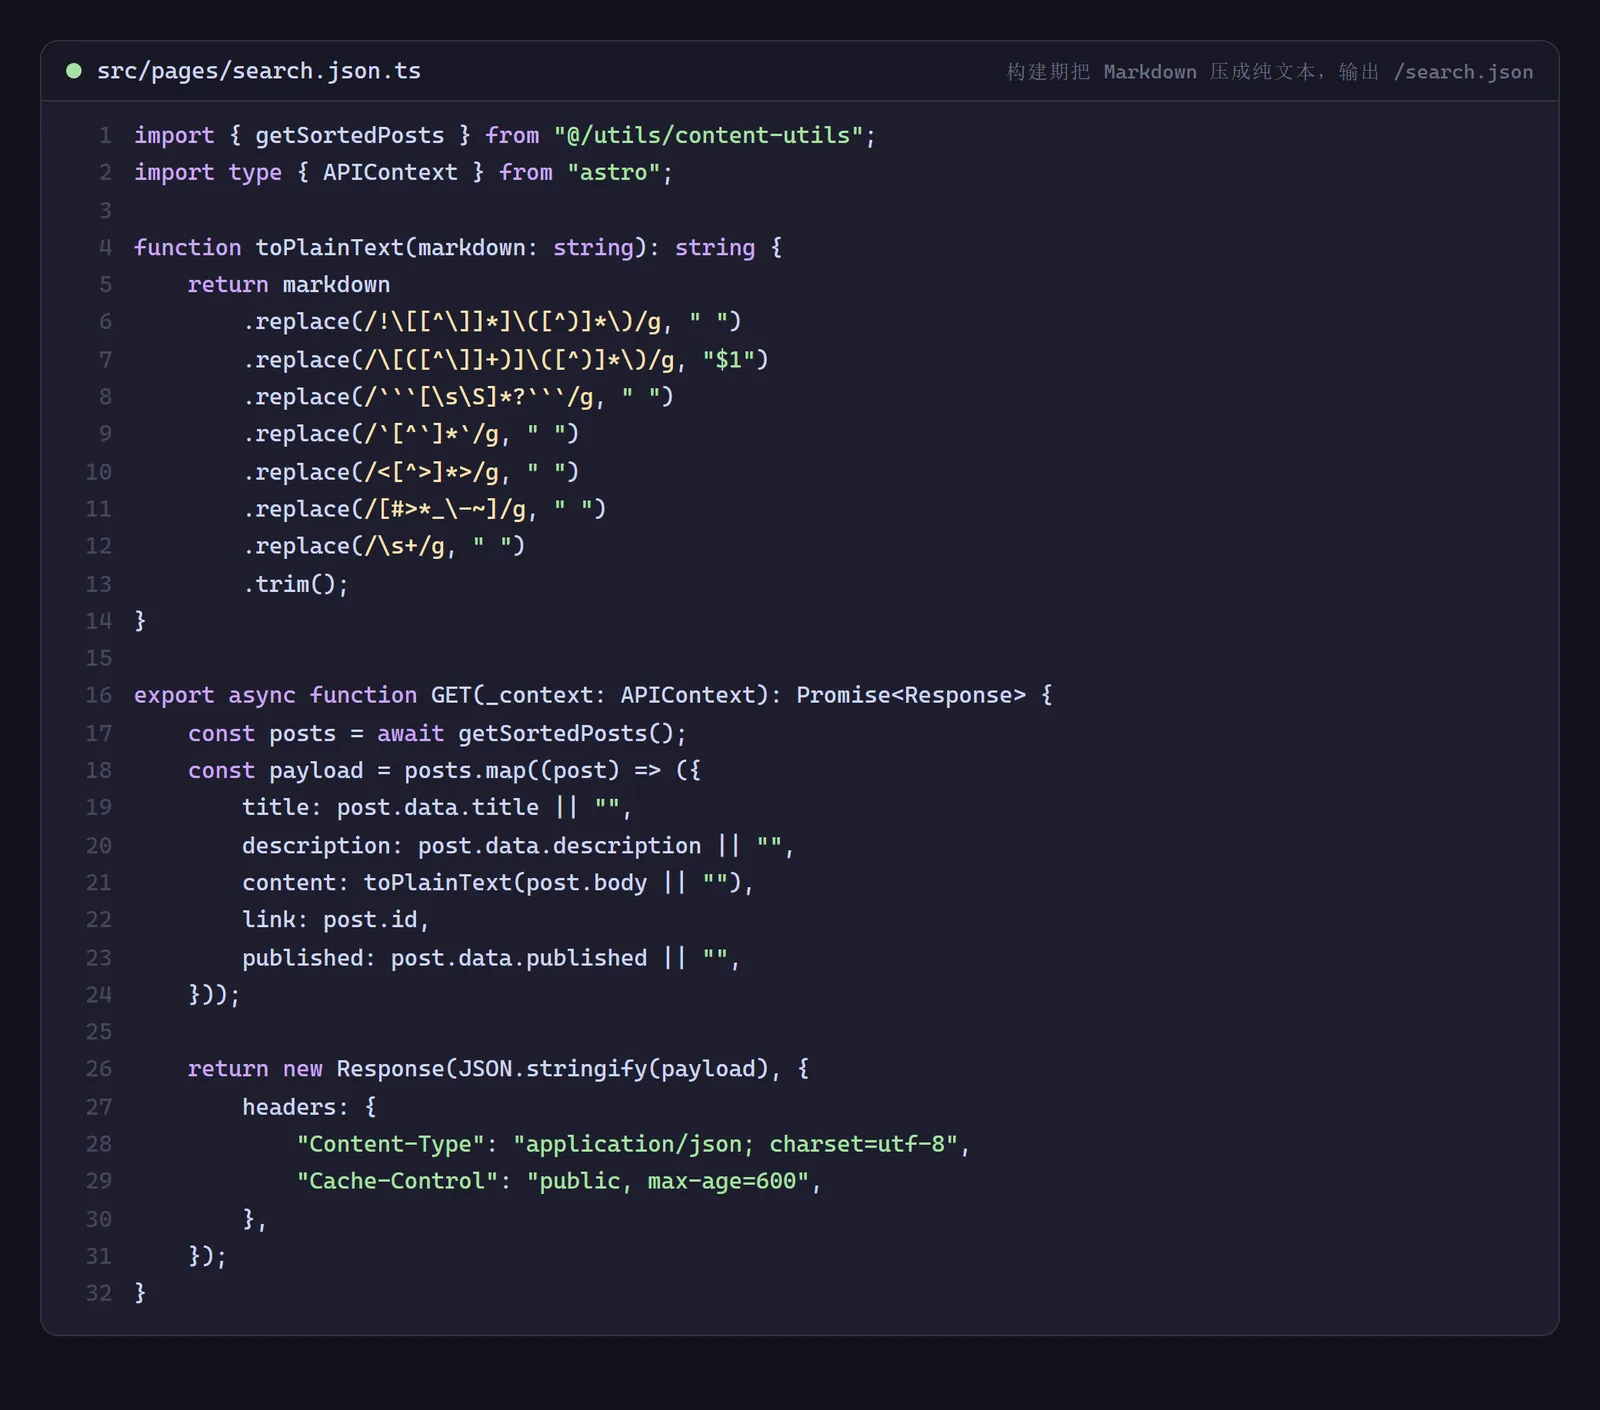
关键就是那个 toPlainText:把 Markdown 一条条削成单行纯文本(下面这段是原文,行尾注释是我为了说明加的):
function toPlainText(markdown: string): string {
	return markdown
		.replace(/!\[[^\]]*]\([^)]*\)/g, " ")   // 图片语法整段丢掉
		.replace(/\[([^\]]+)]\([^)]*\)/g, "$1")  // 链接只留锚文本
		.replace(/```[\s\S]*?```/g, " ")         // 围栏代码块整段丢掉
		.replace(/`[^`]*`/g, " ")                // 行内代码也丢掉
		.replace(/<[^>]*>/g, " ")                // 残留的 HTML 标签
		.replace(/[#>*_\-~]/g, " ")              // Markdown 记号
		.replace(/\s+/g, " ")
		.trim();
}
这个函数决定了搜索能搜到什么、搜不到什么。 被它抹掉的内容不是小数——我拿本地 5 篇已上线文章(hello-world、security-headers-audit、ssllabs-https-grade、traceroute-packet-loss-misread、workers-free-tier-cost)实测过。口径先说清楚:统计的是去掉 frontmatter 之后的正文 Markdown、按 UTF-8 编码的字节数;行内代码按 toPlainText 自己的替换顺序数,也就是在围栏代码块被抹掉之后再数。
- 正文 Markdown 合计 60,863 字节
- 其中围栏代码块 4,036 字节(6.6%)、行内代码 5,472 字节(9.0%)、图片语法 4,258 字节(7.0%)
- 最后压出来的纯文本 45,391 字节,同时压掉了一部分体积
代价很明确:搜不到代码里的关键字。这不是推测——《Cloudflare Workers 免费额度够不够》那篇正文里写过 If-None-Match(在行内代码里),线上搜它是「无搜索结果」;我直接在索引文件里检索 Cache-Control(有两篇文章在行内代码里写过它),同样一个字都没有。取舍是我不想让索引被代码撑大——一篇技术文章的代码块往往比正文还长,全留下的话索引体积翻倍不止。
索引里到底装了什么
直接看线上那份文件的真实输出:
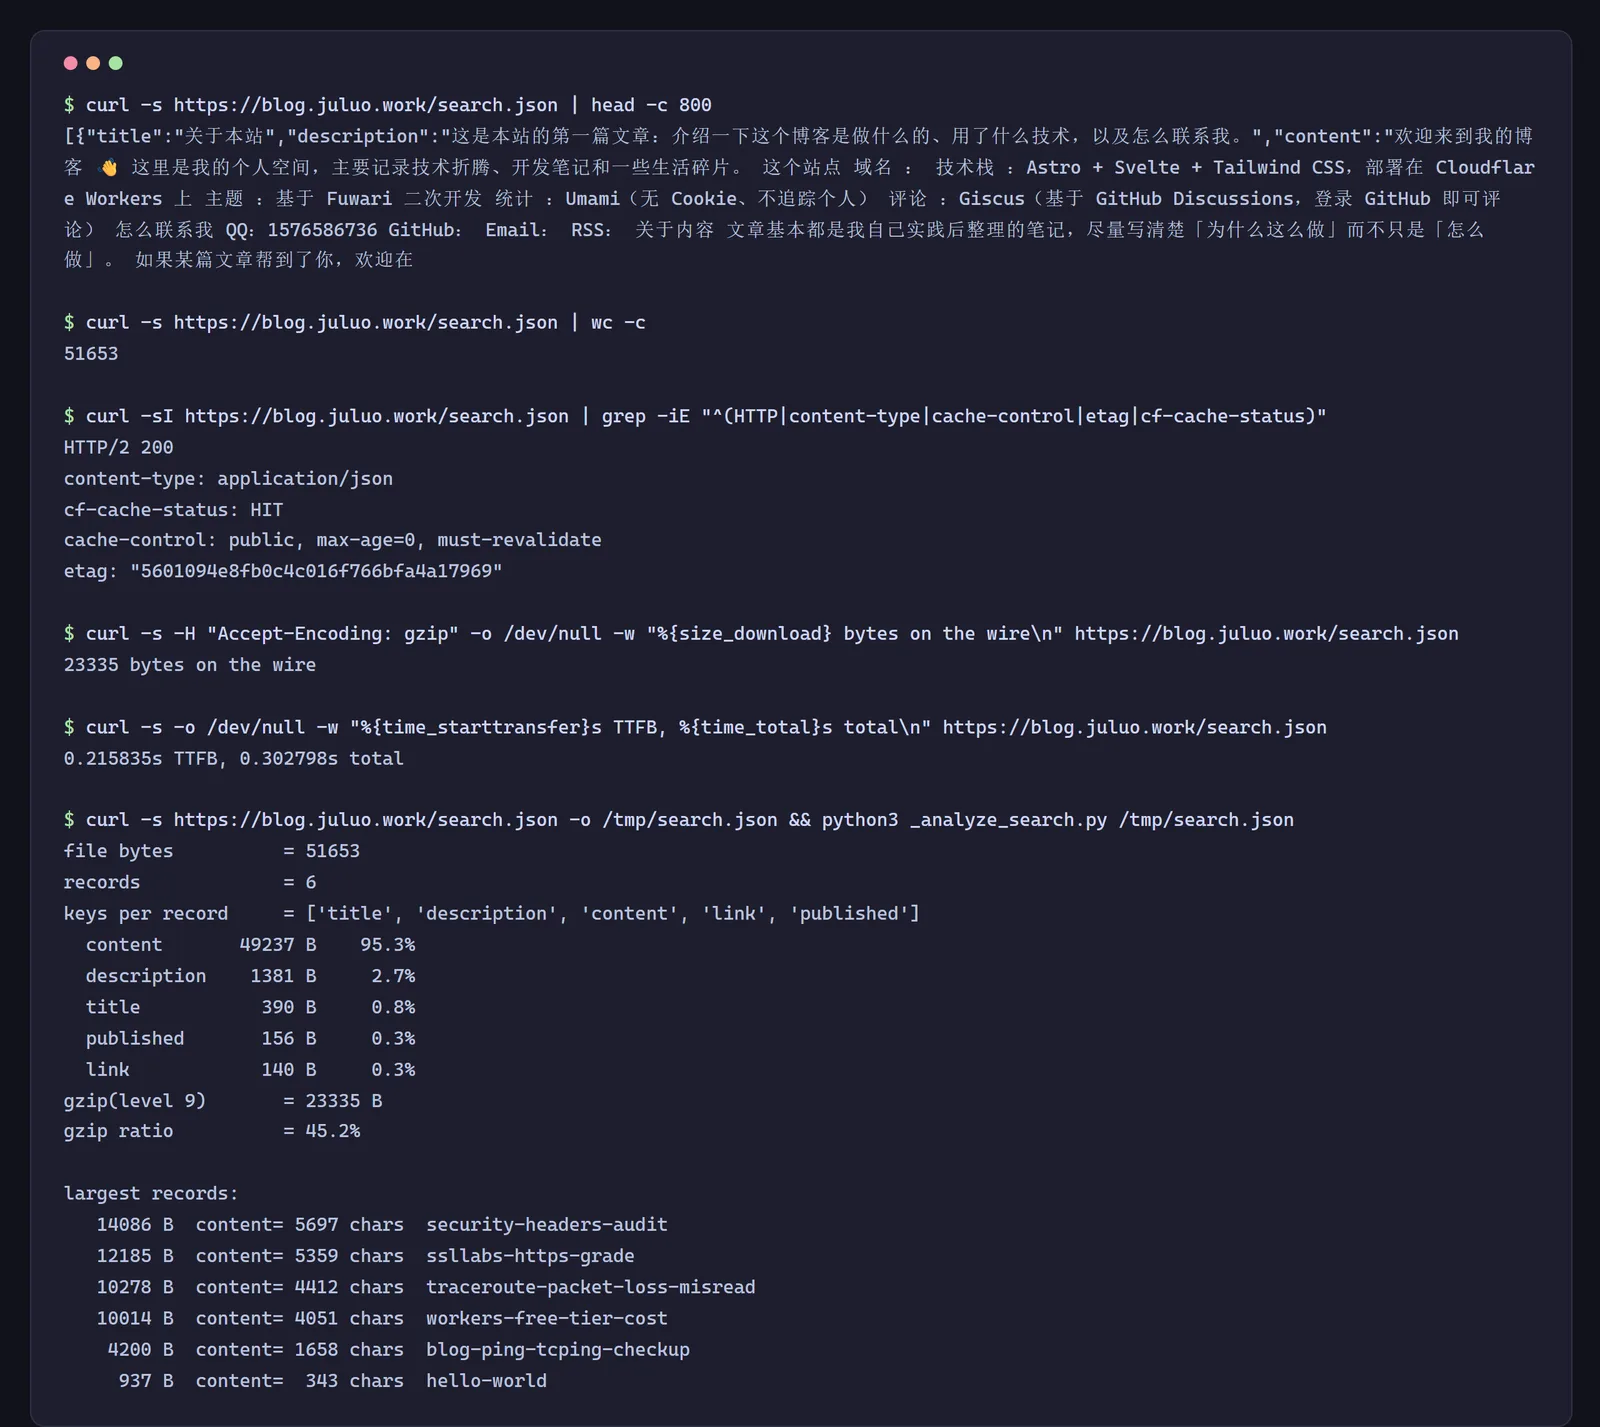
一条记录长这样(content 我手动截断了,其余是原文):
[
  {
    "title": "关于本站",
    "description": "这是本站的第一篇文章:介绍一下这个博客是做什么的、用了什么技术,以及怎么联系我。",
    "content": "欢迎来到我的博客 👋 这里是我的个人空间,主要记录技术折腾、开发笔记和一些生活碎片。 这个站点 域名 : 技术栈 :Astro + Svelte + Tailwind CSS,部署在 Cloudflare Workers 上 …(此处截断)",
    "link": "hello-world",
    "published": "2026-10-05T00:00:00.000Z"
  }
]
只有 5 个字段,每一个都有理由:
title/description:直接来自 frontmatter,前端给它们最高权重content:toPlainText处理后的正文,占了整份索引 95.3% 的字节(49,237 / 51,653 字节)link:post.id,也就是文章的 slug;前端拼成/posts/<link>/当跳转地址published:Date 被JSON.stringify序列化成 UTC ISO 串,前端用new Date()还原后排序。frontmatter 里写的+08:00在这里被换算掉了——文章里写 22:20,索引里就是2026-10-05T14:20:00.000Z
没进去的东西同样是有意为之:tags(搜索里用不上,且会引入重复字符串)、封面图、HTML 渲染结果、目录结构。全部记录加起来 51,653 字节;用 curl -H "Accept-Encoding: gzip" 拉一次,过网 23,335 字节(本地 gzip -9 复算也是这个数),也就是约 23 KB——这是整站里唯一一个「为了某个功能专门下载的数据文件」,其余请求都是样式、脚本和页面本身。
提示「过网体积」有两个口径,别混着用。这里的 23,335 字节,是 curl 显式声明只要 gzip 时拿到的压缩体;后面「代价」一节里浏览器实测的 25,316 字节,是 Chrome 的
encodedBodySize——浏览器声明的是一整串编码(gzip, deflate, br, zstd),具体用哪一种由服务端按协商结果决定,同一行的transferSize还要再加上约 300 字节的响应头开销。差的这 1,981 字节不是谁算错了,是两份字节根本不是同一次压缩的结果;引用之前先想清楚说的是「我要 gzip 能拿到多少」还是「浏览器实际下了多少」。
前端:没有 Fuse.js,也没有模糊匹配
先把一件事说清楚:这套搜索不是模糊匹配,是大小写不敏感的子串精确匹配加权重打分。仓库里搜不到 fuse(git grep -i fuse 无命中,package.json 里也没有这个依赖),从计数、加权到截摘要、排序,全在手写的一个 searchPosts 函数里。
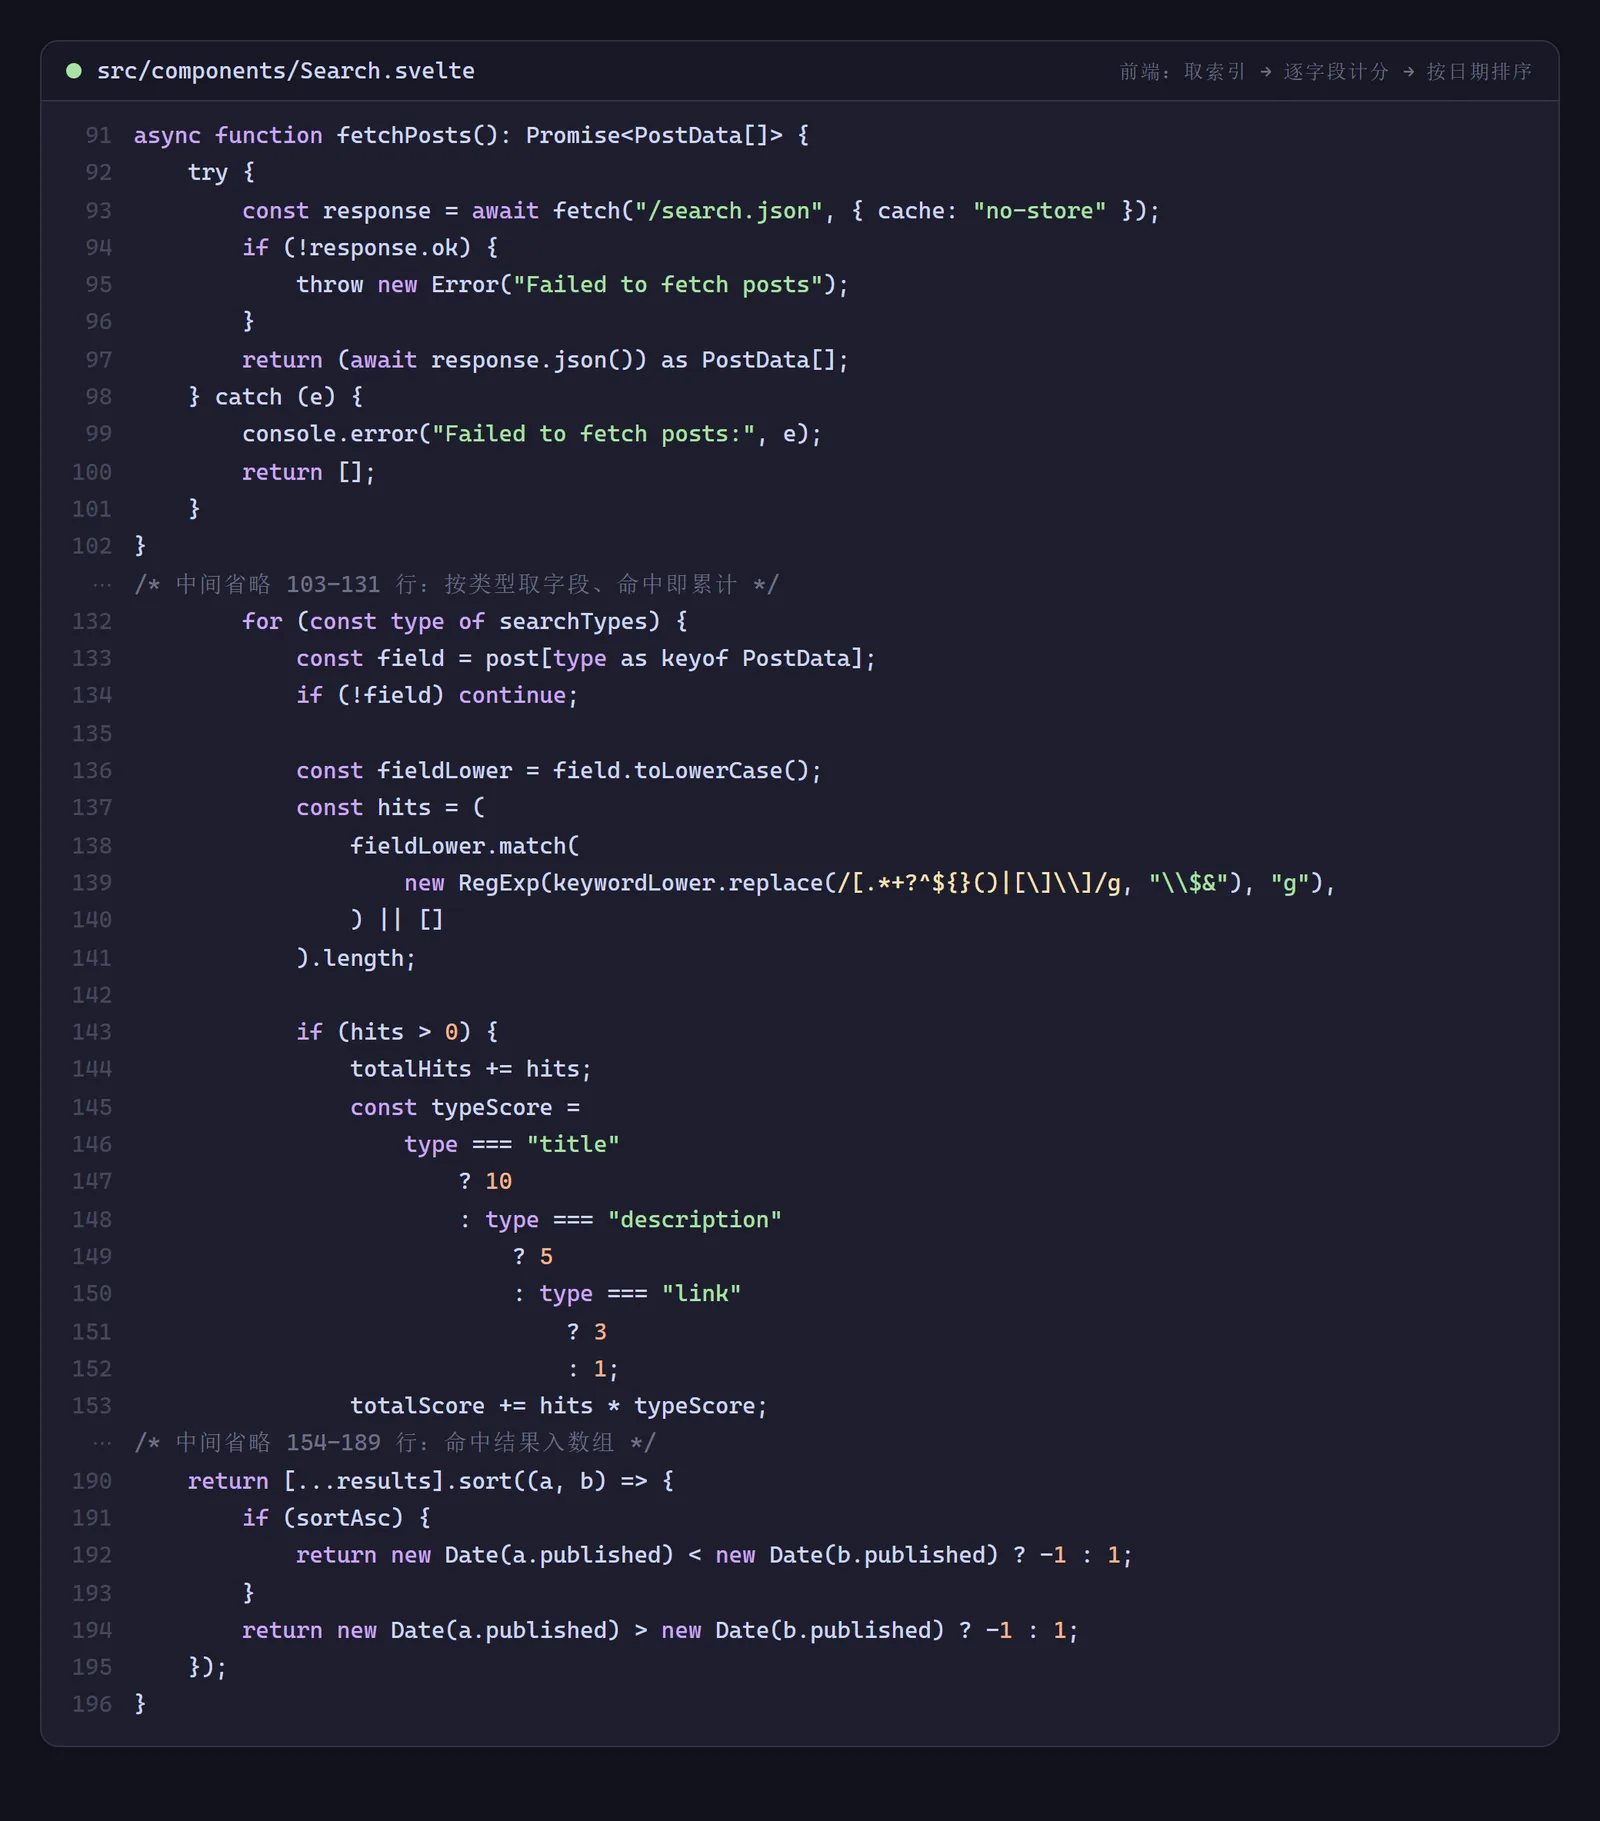
核心是「数命中次数」:
const hits = (
	fieldLower.match(
		new RegExp(keywordLower.replace(/[.*+?^${}()|[\]\\]/g, "\\$&"), "g"),
	) || []
).length;

if (hits > 0) {
	totalHits += hits;
	const typeScore =
		type === "title"
			? 10
			: type === "description"
				? 5
				: type === "link"
					? 3
					: 1;
	totalScore += hits * typeScore;
}
权重是这样定的:标题 10、简介 5、路径 3、正文 1,乘上命中次数累加成 score。关键词先做正则元字符转义再用 String.match 全局匹配,所以用户输入 [、* 这类字符不会炸正则。
到这里有个我在读代码时才发现的事实:score 算出来了,但没被用。 结果列表最后是按 published 排序的(默认最新优先,有个按钮切成最旧优先),界面上展示的是 hitCount(「命中 N 次」),score 只是被塞进结果对象里带了一路。也就是说打分的权重目前对搜索结果顺序毫无影响——它现在是个可以删掉的字段。我没动它,但这是个典型的「写的时候打算用来排序、后来改成按日期排就忘了删」。
另外两个细节:高亮是把关键词包成 <mark class="hl"> 后用 {@html} 注入的,main.css 里把 .search-panel mark 设成透明背景加主题色;摘要片段取命中位置前后各 40 个字符,两端补 ...,所以短关键词的上下文是够看的。
交互细节:中文输入法是最容易被忽略的那个
搜索框在顶栏,桌面端一个、手机端一个,都是 bind:value 双向绑定。真正花心思的地方在输入法:
<input placeholder="搜索" bind:value={keyword} on:focus={() => { void reopenPanelIfHasQuery(); }}
       on:input={sanitizeKeyword}
       on:compositionstart={() => { isComposingDesktop = true; }}
       on:compositionend={() => { isComposingDesktop = false; sanitizeKeyword(); }}
中文输入法在敲拼音的过程中会持续触发 input 事件。如果不拦,输入「zhongwen」时拼音中间态会被当成关键词查一轮,白白拉几次索引。所以组件用 compositionstart / compositionend 标记组合态,组合期间不触发搜索。sanitizeKeyword 则把关键词里的空白全删掉——实测输入 cloud flare,输入框里会变成 cloudflare,结果依然是 6 条。
面板里还有一排类型筛选(标题 / 简介 / 正文 / 路径),默认是单选,勾上「多选」可以组合。实测选「标题」后结果从 6 条降到 3 条,正好是标题里含 Cloudflare 的那三篇。输入 zzzznothing 时面板显示「无搜索结果」。
面板的开合不靠 Svelte 状态,而是直接操作 class:setClickOutsideToClose("search-panel", [...]) 在 document 上挂了点击监听,点到面板和三个搜索框以外的地方就加 float-panel-closed(CSS 里是 -translate-y-1 opacity-0 pointer-events-none)。实测点一下页面空白处,面板的 class 里立刻多出 float-panel-closed。
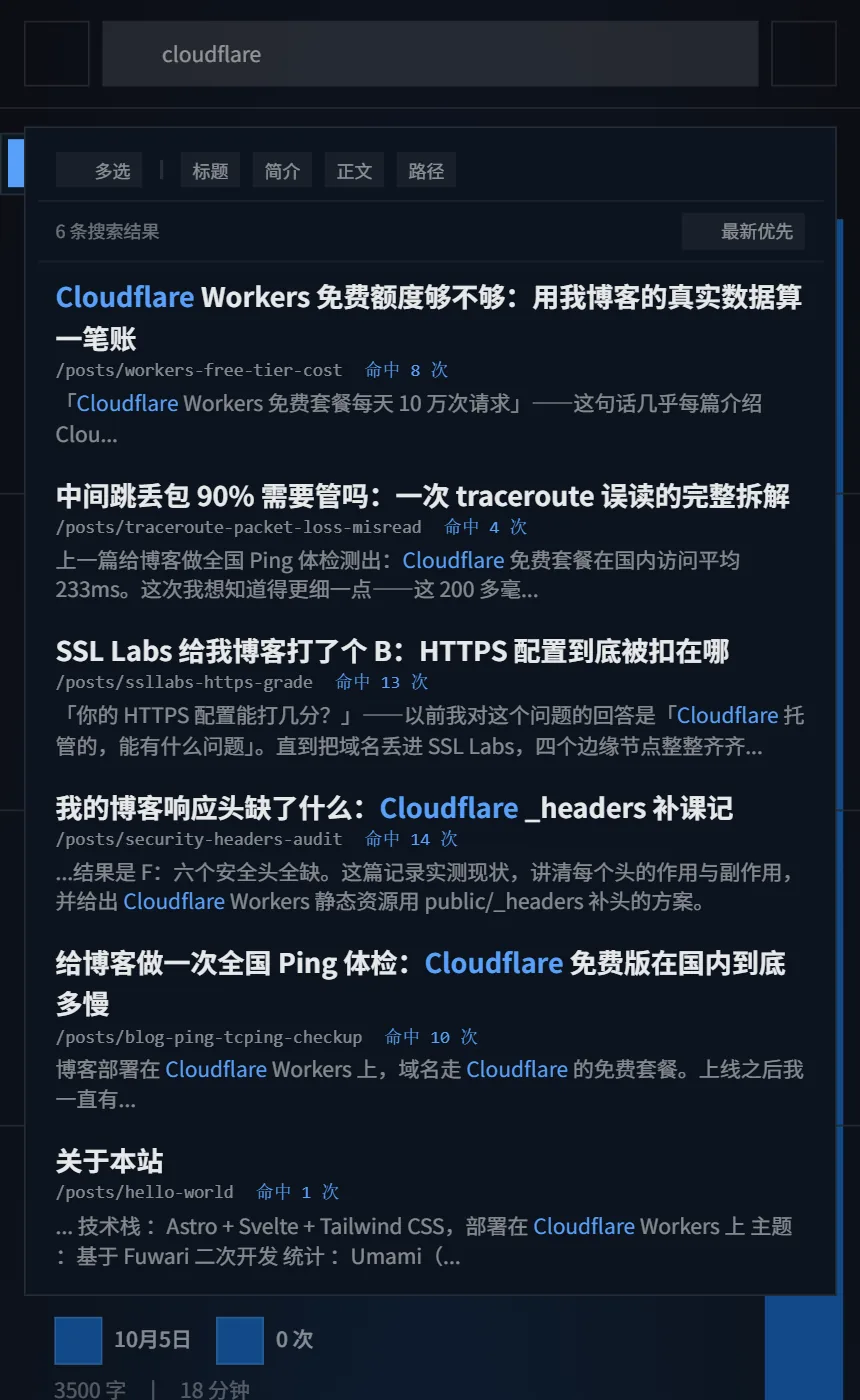
手机端的搜索框在展示上和桌面端不一样:#search-bar 在 430px 宽度下 display:none,用的是 #search-bar-mobile。顺带发现面板里那个 #search-bar-inside 输入框是死代码——它带着 hidden 类,在桌面和手机两种视口下实测都是 display:none,代码里只剩「点击外部时忽略它」这一处引用。这个我没清理,怕动布局出错。
还有一件我确实没做的事:没有快捷键。git grep keydown 在整个 src 下只有 fancybox 一处,搜索框没有 Ctrl+K、也没有 /。做静态博客的人很容易忘记「用户想搜的时候得先找到搜索框」,这个我记在待办里。
代价:每敲一个字都重下一次索引
这是整套方案里最实在的问题,我把它量化了:
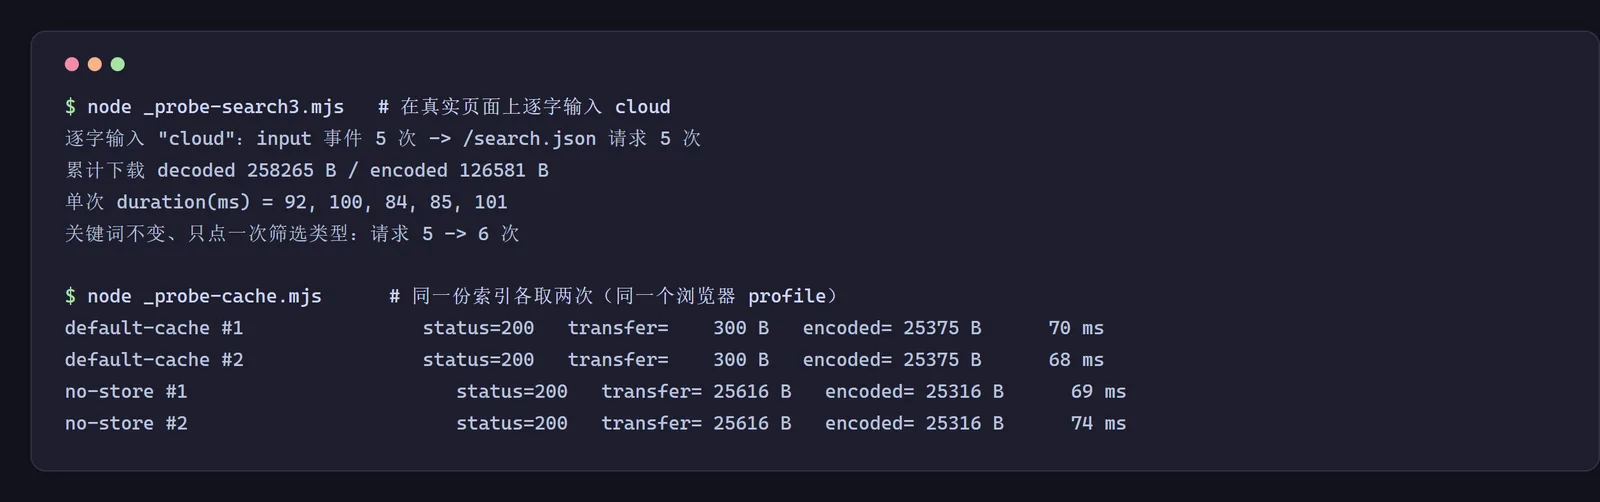
在真实页面上用 350ms 间隔逐字敲 cloud(5 次 input 事件),/search.json 被请求了 5 次,累计下载 258,265 字节(decoded),过网 126,581 字节(encoded),单次耗时 84~101ms。关键词不变、只点一下类型筛选,请求数又从 5 变成 6。
原因在 fetchPosts 里这一行:
const response = await fetch("/search.json", { cache: "no-store" });
以及那个响应式块:keyword 或 selectedTypes 一变,就重新 fetchAndSearch。no-store 明确禁止浏览器缓存这份响应,所以每次都得走网络重新拿全量。有意思的是,服务端其实是支持条件请求的——带上 If-None-Match 再请求一次,返回的是 304,只要几百字节;而 cache: "no-store" 让浏览器根本没机会发这个条件请求。
同一份索引各取两次的对比更直观:默认缓存下浏览器本地已有副本,两次都只花 300 字节(走 304 复验);no-store 下两次都是 25,616 字节全量。
小贴士这就是这套实现里我准备先改的地方:去掉
no-store或者把已经拿到的allPosts复用起来,两个改动都很小,能把「敲 5 个字符下 250 KB」压到几乎为零。写这篇的时候还是老样子,所以文章里的数字都是老的。
踩过的坑
1. 在 API 路由里写 Cache-Control 是没用的。 search.json.ts 里明明写的是 "Cache-Control": "public, max-age=600",线上 curl -sI 拿到的是 public, max-age=0, must-revalidate + ETag。/posts.json、/rss.xml 三条一样,说明这是 Workers 静态资源层统一加的头——纯静态输出下,路由返回的响应头根本落不到文件上(这个话题在《我的博客响应头缺了什么》里写过一次)。想改的话,最省事的是 public/_headers(Workers 静态资源也支持这套规则),或者在 Worker 逻辑里自己改响应头;而仓库里目前没有 _headers 这个文件。
2. PowerShell 会把 ETag 的引号吃掉,导致误判「服务端不支持 304」。 我第一次测条件请求,用 curl.exe -H "If-None-Match: $etag" 发出去,请求头变成了不带引号的 If-None-Match: 5601094e…,服务端当然认为不匹配,返回 200 加完整内容。换成在 bash 里跑、引号保留,同一个 ETag 立刻返回 304——那个 288,727 字节的 CSS 也一样返回 304。顺带说一句:《Cloudflare Workers 免费额度够不够》里「带 ETag 重发没有 304」那条结论,多半就是吃了这个亏(当时测的是同一类请求)。测量脚本本身出错,比被测对象出错更常见。
3. results.sort() 原地排序把面板搞没了。 这一条不是我自己踩出来的,是主题上游的历史修复:提交 37dd9a3b 把 return results.sort(...) 改成了 return [...results].sort(...),修的是「排序功能上线后第一次点排序按钮,面板消失」。这个提交的作者是主题原作者(二叉树树),不是本站主人。原地排序动的是同一个数组引用,上游没解释 Svelte 的响应式在这里具体怎么判定,我也没复现这个 bug,只能照着修法倒推原因。
4. 排序条件不能靠重新搜索。 点排序按钮如果重新走一遍 fetchAndSearch,就又要下载一次索引。现在的写法是把第一次的结果存进 allPosts,再用第二个响应式块只重算不重取。这也是前面那个「点筛选却多了一次请求」的来源——筛选条件变更走的是第一条路径。
5. Astro v6 升级后 entry.slug 变成 entry.id。 这一条同样是上游留下的历史,不是本站主人的功劳:索引里的 link 字段现在直接来自 post.id,而把 entry.slug 全部换成 entry.id 的是上游提交 a4332e21(作者同为主题原作者),那一次连带着 RSS、sitemap、卡片组件、search.json.ts 一起替换,不然文章链接会渲染成 undefined。这段经过我是从它的提交信息和 diff 里读出来的。
6. 索引的新鲜度等于部署的新鲜度。 我本地刚删掉一篇文章,线上索引里照样能搜到它,因为它是在上一次部署时烘进去的。静态索引没有「数据过期」这回事,只有「没重新部署」。
什么情况下继续用它
判断标准我给自己列了三条:
- 文章数在 50 篇以内、索引 gzip 后还在 300 KB 以下:继续用。零依赖、可
curl验证、改一行代码就能调权重。 - 需要拼音搜索、错字容错、或者搜代码块里的内容:换方案。现在的实现是子串精确匹配,
k8s搜不到Kubernetes,被toPlainText抹掉的代码块也永远搜不到。 - 文章超过 100 篇:必须换。按现在平均 8.6 KB/篇推算,100 篇的索引约 860 KB,
no-store下敲五个字符就是几 MB 流量,这对读者和免费额度都不友好。
近期我会按这个顺序改:先去掉 no-store 并把 allPosts 复用起来(省掉绝大部分重复下载),再把没用上的 score 删掉或者真正接进排序,最后才是考虑换掉整套方案。
一份 JSON 索引加一个手写的匹配函数,能撑多久取决于你写多少字——它现在撑得住,但它不是那种「可以放着不管」的实现:每加一篇文章,索引就大一点,而每次搜索都要把它整个搬一遍。
搜索索引和文章修订历史都依赖同一套内容集合,两者的构建期处理可以放在一起看。
发现错误或想要改进这篇文章?
在 GitHub 上编辑此页文章修订历史 (1 次)
查看变更记录
docs(baseline): 第 30 轮终检——数字更新到最终状态,补第 28~30 轮小结
相关文章
- 给每篇文章加「更新记录」:用 git 提交历史自动生成文章修改时间线文章页底部那块「更新记录」不是手写的:构建前用脚本读 git log 生成 JSON,页面再按 slug 查表渲染。本文拆开这条链路,讲清 fetch-depth 0 为什么是硬前提、浅克隆会怎样把一条无关提交按到所有文章头上,以及行内 diff 编辑器的取舍。
- 静态博客怎么显示每篇文章的浏览量:从 D1 读数接口到前端排序的完整链路静态站没有后端,文章卡片上的浏览量到底从哪来?这篇拆我自己这套链路:D1 里只有 pathname + views 两列、两个读接口的分工、前端如何一次批量取数并先藏后显避免抖动、列表页按热度排序的索引对齐,以及防刷与缓存口径的取舍。
- 27 篇文章的站内搜索:81 KB 索引与一次 304静态站没有后端,站内搜索只能在构建期做索引、在浏览器里做匹配。这篇记录现在这套方案的实现与实测(索引 81 KB、首搜 422 ms),顺手修掉「每次搜索都重新下载索引」的问题,并说清它在多少篇文章之后会撑不住。