给每篇文章加「更新记录」:用 git 提交历史自动生成文章修改时间线
「这篇文章是什么时候改的?」——这是我做博客时第一个没解决的问题。frontmatter 里的 updated 是我手填的:勤快的时候会更新,改个错别字的时候不会;而且读者没有任何办法验证它。最后我在文章页底部放了一块「更新记录」,列的是这篇文件在 git 里的真实提交,带日期、短哈希、提交信息,点哈希直接跳到 GitHub 的 commit 页。
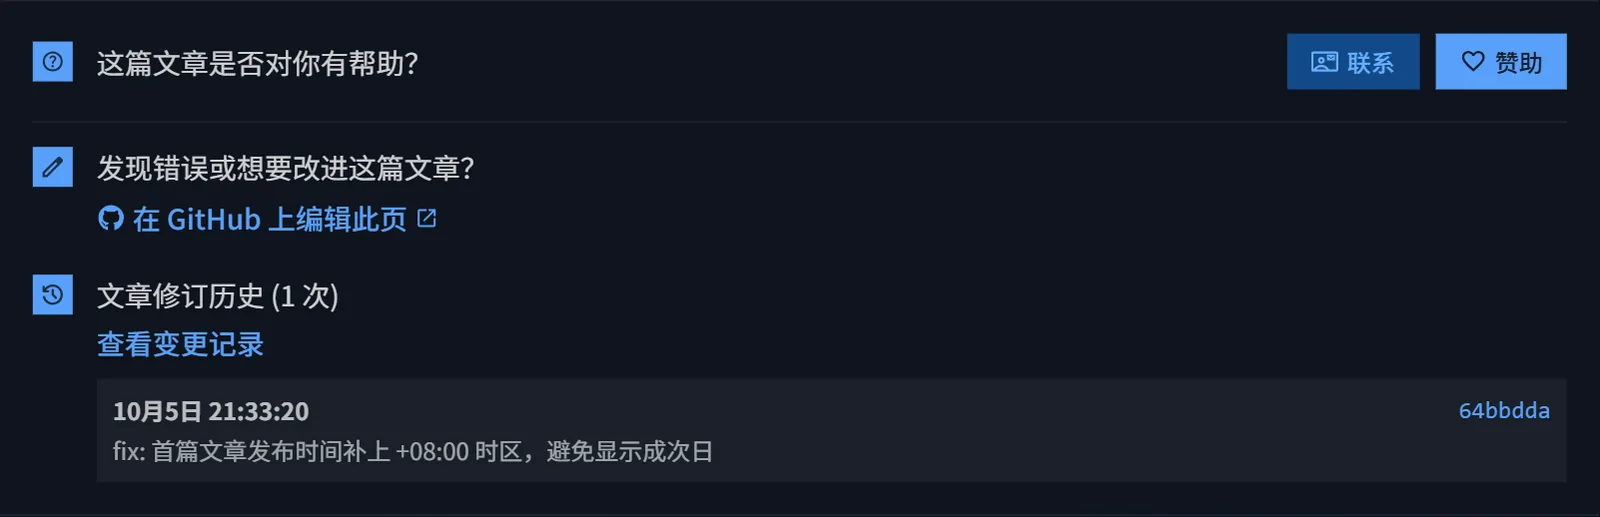
下面是线上渲染出来的样子。但先别信它——图里那条提交跟截图里那篇文章毫无关系,第四节会讲清楚为什么。
提示站点环境:Astro 6 静态站,部署在 Cloudflare Worker 的静态资源模式,构建由 Workers Builds 从 GitHub 的
main分支跑pnpm update-diff && pnpm astro build --force。本文所有命令输出都是 2026-10-05 在本机真实执行的(Windows + Node v24.16.0 + git 2.53.0)。
一、为什么用 git 历史,而不是别的数据源
做「更新时间线」有三条路,我都想过:
手写 updated 字段。最省事,但它是自我声明,不是事实。我改一篇文章的时候经常只改正文忘了改字段,时间线立刻失真。
读文件系统 mtime。这个方案听起来很干净,实际完全不能用:CI 上克隆下来的文件,mtime 全是 checkout 那一刻的时间,跟文章的真实修改时间没有任何关系。本机看着正常、线上全是同一个时间戳,比不做还糟。
读 git 提交历史。时间、作者、说明、可点击的详情页,全都是现成的,零额外维护成本。代价是构建机上必须有完整的 git 历史——这正是第四节那个坑的来源。
我选了第三条。它多出来的成本只有一项:构建前要多跑一个脚本。
二、上半段:构建前把 git log 压成一个 JSON
链路起点是 scripts/update-diff.js,pnpm update-diff 就是跑它。它干的事情非常直白:遍历 src/content/posts 下的所有 .md / .mdx,对每个文件跑一次 git log。
const git = spawn('git', [
    'log',
    '--follow',
    '--pretty=format:%H|%ad|%s',
    '--date=iso',
    '--',
    filePath
]);
--follow 是必须的:文章改过 slug、挪过目录之后,不带这个参数历史会从改名那一刻断掉。
输出的每一行长这样:<完整哈希>|<ISO 日期>|<提交信息>。解析部分有个细节值得看一眼——注释里写着「message might contain |」:
const firstPipe = line.indexOf('|');
const secondPipe = line.indexOf('|', firstPipe + 1);

if (firstPipe === -1 || secondPipe === -1) return null;

const hash = line.substring(0, firstPipe);
const date = line.substring(firstPipe + 1, secondPipe);
const message = line.substring(secondPipe + 1);
它没有用 split('|'),而是手工定位前两个竖线再切三刀。这样即使提交信息里带竖线(我写提交信息时经常带表格或命令行片段),后面的内容也会原样落到 message 里,不会被截断。
文章一多,这里就是几十上百次子进程,所以脚本用了 spawn 而不是 exec,并且按 CPU 核数分块并发:
const MAX_CONCURRENCY = Math.max(1, os.cpus().length - 1); // Leave one core free
本机 16 核,所以运行时打印的是 Using concurrency: 15。这里刻意留一个核给主进程,避免脚本自己把机器占满。
还有一个设计我很喜欢——单篇失败不拖垮整体:
if (code !== 0) {
    console.warn(`Failed to retrieve git history for ${filePath}: ${error}`);
    resolve([]); // Resolve empty on error to keep going
    return;
}
git 命令非零退出、或者 spawn 本身报错,都只是 resolve([])。一篇文章查不到历史(比如刚 git add 还没提交),页面上少一块时间线而已,不该让整站构建挂掉。
最后,键名用的是文件相对 src/content/posts 的路径,并强制转成正斜杠:
const relativePath = path.relative(CONTENT_DIR, file).replace(/\\/g, '/');
const history = await getGitHistoryAsync(file);
historyMap[relativePath] = history;
这行 replace(/\\/g, '/') 是 Windows 上开发必须要的:不然本机生成 ssllabs-https-grade.md,Linux 构建机上生成 posts\ssllabs-https-grade.md,页面里查表全落空。
跑完之后产出 src/json/git-history.json:
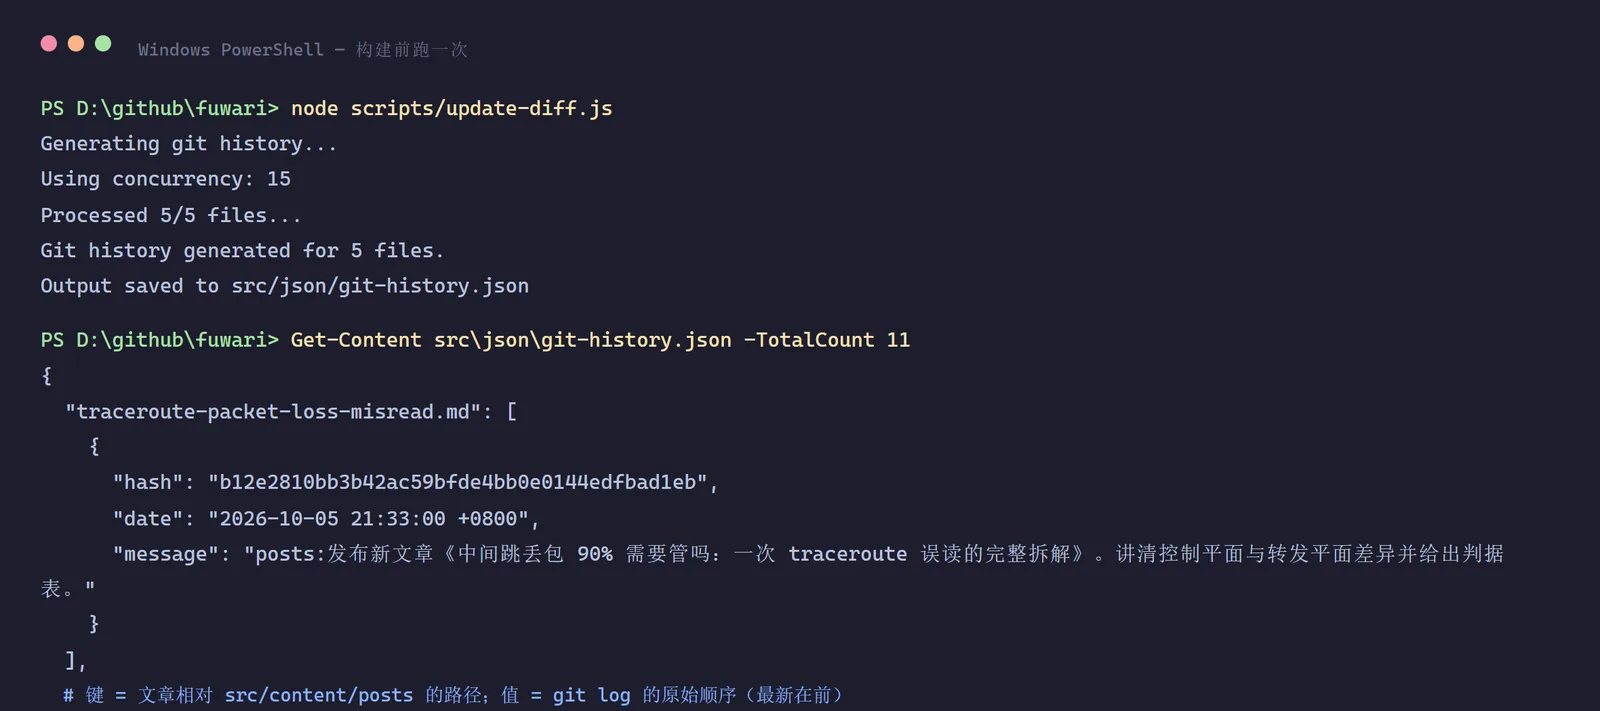
这个文件是生成物,已经写进 .gitignore(仓库最后一行就是 src/json/git-history.json),不进版本控制,每台机器构建时现算。代价是构建顺序变成了硬约束:src/utils/git-history.ts 第 4 行是静态 import,
import gitHistory from "../json/git-history.json";
文件不存在时 Vite 直接在解析阶段报 Could not resolve "../json/git-history.json"。仓库的 docs/workers-deploy.md 专门为此写了一条:Build command 里的 pnpm update-diff 必须保留。我的看法是:让构建失败比让页面悄悄少一块好——所以这个「硬约束」我认。
每篇文章起一个 git 进程,文章数上去以后这一步会是构建里最先变慢的环节。我还没到那个量级,暂时按 cpus - 1 并发扛着,不提前优化。
三、下半段:页面按 slug 查表
文章页要拿历史,只有一行:
const history = getPostHistory(entry.id);
const lastUpdateTime =
	history[0]?.date || entry.data.updated || entry.data.published;
getPostHistory 做的事就是「补扩展名 + 查表」,但这个补扩展名是整条链路里最容易断的一环:
export function getPostHistory(postId: string): Commit[] {
	try {
		// Normalize ID to match keys in JSON (forward slashes)
		let normalizedId = postId.replace(/\\/g, "/");

		// Add .md extension if not present (entry.id doesn't include extension)
		if (!normalizedId.endsWith('.md') && !normalizedId.endsWith('.mdx')) {
			normalizedId += '.md';
		}

		// Look up in the pre-generated history map
		const historyMap = gitHistory as Record<string, Commit[]>;

		if (historyMap?.[normalizedId]) {
			return historyMap[normalizedId];
		}

		return [];
	} catch (e) {
JSON 的键是带扩展名的文件名,而 Astro 内容集合给的 entry.id 是不带扩展名的(ssllabs-https-grade)。两边靠这里补一个 .md 对齐——代码注释里也是这么写的。哪天换成别的 loader、或者文章改成 .mdx 以外的后缀,这里对不上,函数返回空数组,页面只是不渲染那一块,不抛错、不报警。这类静默退化是我后来加自检的原因。
渲染部分是普通的折叠块,但有几处体现了取舍:
{history.length > 0 && (
    <div id="revision-history" class="flex items-start gap-3 mt-4 scroll-mt-20">
        <div class="h-5 w-5 bg-[var(--primary)] flex items-center justify-center">
            <Icon name="material-symbols:history-rounded" class="text-[0.875rem] text-black/70"></Icon>
        </div>
        <div class="flex-1">
            <p class="text-white/80 text-sm mb-1">文章修订历史 ({history.length} 次)</p>
            <details class="group">
                <summary class="cursor-pointer text-sm text-[var(--primary)] font-medium hover:underline select-none">
                    查看变更记录
                </summary>
                <div class="mt-2 space-y-2 max-h-48 overflow-y-auto">
                    {history.map(commit => (
                        <div class="flex flex-col text-xs bg-white/5 p-2">
                            <div class="flex justify-between items-center mb-1">
                                <span class="font-bold text-white/70">{formatPostDateForDisplay(new Date(commit.date))}</span>
                                <a href={getCommitUrl(commit.hash)} target="_blank" class="text-[var(--primary)] hover:underline font-mono">
                                    {commit.hash.substring(0, 7)}
                                </a>
                            </div>
                            <p class="text-white/60 break-all">{commit.message}</p>
                        </div>
                    ))}
                </div>
            </details>
        </div>
    </div>
)}
几点说明:
- 默认折叠 +
max-h-48 overflow-y-auto。改过几十次的文章不会把页面撑开,代价是读者必须多点一次才能看到内容。 history[0]被当成「最后修改时间」。这里依赖git log默认的「新提交在前」,脚本没有额外排序,页面也没排。约定是靠 git 的默认行为撑着的,没有断言保护。lastUpdateTime的兜底顺序是「git 历史 → frontmatter 的 updated → published」。这个值会喂给PostUpdateNotice,用来算「文章初次发布于 N 天前,最后修改于 M 天前」。所以 git 历史不只是装饰,它还参与页面上的时效性提示。- 短哈希 +
getCommitUrl:函数从gitHubEditConfig.baseUrl(https://github.com/juluowork/fuwari/blob/main/src/content/posts)里截掉/blob/之后的部分,拼成/commit/<hash>。只要「编辑本文」那个配置是对的,commit 链接就自动对,不用配第二个地址。 - 一个我不太满意的耦合:整块(编辑入口 + 修订历史)被
{gitHubEditConfig.enable && (...)}包着。也就是说关掉「在 GitHub 上编辑此页」,修订历史会一起消失。想只关编辑链接、保留历史,得先拆这层结构。我暂时留着——两个功能指向同一个仓库,一起开关也说得通。
四、浅克隆会把别人的提交按到你头上
上面这条链路在本机跑得好好的。但线上是错的。
写作时线上挂着 6 篇文章,我把它们的页面全抓了一遍。那 6 篇里有一篇当晚就被我删掉了(选题没价值),所以下表只列现在还挂着的 5 篇:
| 线上文章 | 显示的提交 | 显示的提交信息 |
|---|---|---|
hello-world | 64bbdda | fix: 首篇文章发布时间补上 +08:00 时区,避免显示成次日 |
security-headers-audit | 64bbdda | 同上 |
ssllabs-https-grade | 64bbdda | 同上 |
traceroute-packet-loss-misread | 64bbdda | 同上 |
workers-free-tier-cost | 64bbdda | 同上 |
五篇文章,同一条提交。而这条提交在本地仓库里只动过一个文件——正是当晚被我删掉的那篇,跟上面这五篇一篇都不沾边:
$ git show --stat --oneline 64bbdda
64bbddad fix: 首篇文章发布时间补上 +08:00 时区,避免显示成次日
 src/content/posts/【已删除的那篇】.md | 2 +-
 1 file changed, 1 insertion(+), 1 deletion(-)
(上面那行文件名我换成了占位符:那篇已经不在仓库里了,git show 的原始输出是它的完整路径。)
换句话说:这五篇没有一篇是对的,全被贴了一条跟自己无关的提交。
原因不在脚本,在克隆深度。线上那次构建时,远端 main 的顶端就是 64bbdda,而构建机拿到的是一个浅克隆——整个克隆里只有那一个提交。在浅克隆里,唯一被 fetch 到的提交被当成根提交,而 git log -- <path> 对根提交的判定会退化成「这个路径存在于它的树里吗」。所有文章都在那棵树里,于是每篇文章都拿到了同一条提交。
我在本机复现了一遍:先 git clone --depth 1 建一个浅克隆,再往里补上两次父提交、把浅边界退到 64bbdda(也就是线上那次构建看到的顶端),然后 checkout 过去——这样克隆里依然只有一个提交,正好复现出线上那次构建的状态。
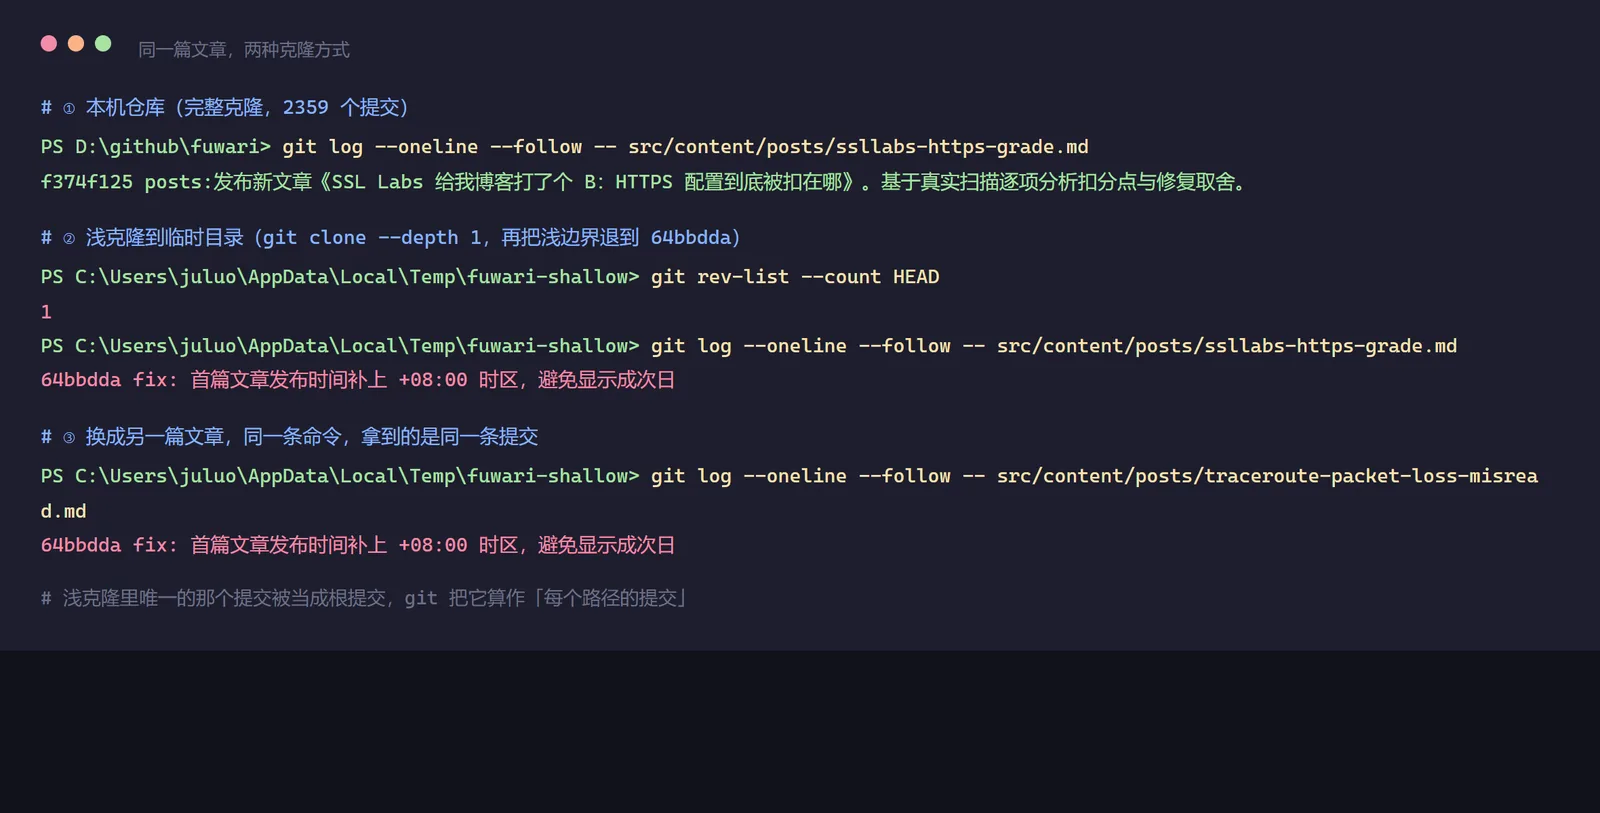
写作时本机这个完整克隆有 2359 个提交,--follow 只返回 f374f125 那条——那才是 SSL Labs 那篇真正的提交;浅克隆只有 1 个提交,同一个命令在两篇不同文章上返回了同一条 64bbdda。
这里有个容易误判的地方:浅克隆的症状不是「历史为空」,而是「所有文章共享同一条最新提交」。脚本对每条 git 命令只看退出码,浅克隆里 git log 退出码是 0、输出格式也完全合法,JSON 生成得漂漂亮亮,页面渲染得整整齐齐——错的只有内容。这种静默错误,只有把线上页面和本地 git log 对一遍才抓得出来。
顺带说明:现在每篇文章只有 1 条记录,不是因为功能坏了,而是站点刚建起来——我拿 git log --oneline --follow -- src/content/posts/<slug>.md 把当时仓库里现役的 5 篇文章挨个查了一遍,每篇都只有 1 条,就是各自的发布提交。历史要等后续修改才会变长。
(顺带一提,「每篇只被提交过一次」这话有个反例:当晚被我删掉的那篇,在历史里有两条改到文件内容的提交——一条发布、一条修正,而那条修正提交正是上面的 64bbdda;删掉它之后,历史里还多出一条删除记录。所以这个「一次」的统计口径只能限定在现役文章上。)
那为什么没配 fetch-depth: 0?因为现在没有地方配。构建跑在 Cloudflare Workers Builds 上,它的 Build settings 里能填的只有 Git 仓库 / 分支、Build command、Deploy command、Preview command、Root directory 和构建期环境变量,没有克隆深度这一项;同一页文档也明确说它不读 wrangler 配置里的 Custom Builds。actions/checkout 时代那种 with: fetch-depth: 0 在这里没处可写。
仓库里其实留着一条老路。停用的 .github/workflows/deploy.yml-nouse 里,构建步骤是这样的:
- name: Build
  run: git clone https://github.com/juluowork/fuwari temp && cd temp && pnpm update-diff && cd .. && mkdir -p src/json && mv -f temp/src/json/git-history.json src/json/git-history.json && rm -rf temp && pnpm build:cdn
它没有给 actions/checkout 传 fetch-depth,而是另外完整克隆了一份到 temp/、在里面跑 update-diff、再把 JSON 搬回来。不管当时作者是怎么想的,效果就是用一次全量克隆绕开浅检出。这条思路今天依然有效,只是执行位置从 Actions 挪到了 Build command 里。
我本机验证过的修法是先补历史再生成:
git fetch --unshallow && pnpm update-diff && pnpm astro build --force
在刚才那个 --depth 1 的克隆里跑 git fetch --unshallow,浅边界消失、历史整段补回来(提交数从 1 回到两千多;写作时本机 HEAD 是 2359 个提交),同一条 --follow 立刻返回正确结果;再跑 update-diff,生成的 JSON 里每篇文章都拿到了各自那条提交。
补完历史后,本地渲染出来的正确结果是这样的——还是第一张图那个页面,也就是《中间跳丢包 90% 需要管吗》那篇;哈希 b12e281,对应的提交是 b12e2810「posts:发布新文章《中间跳丢包 90% 需要管吗:一次 traceroute 误读的完整拆解》」,正是这篇文件自己的发布提交:
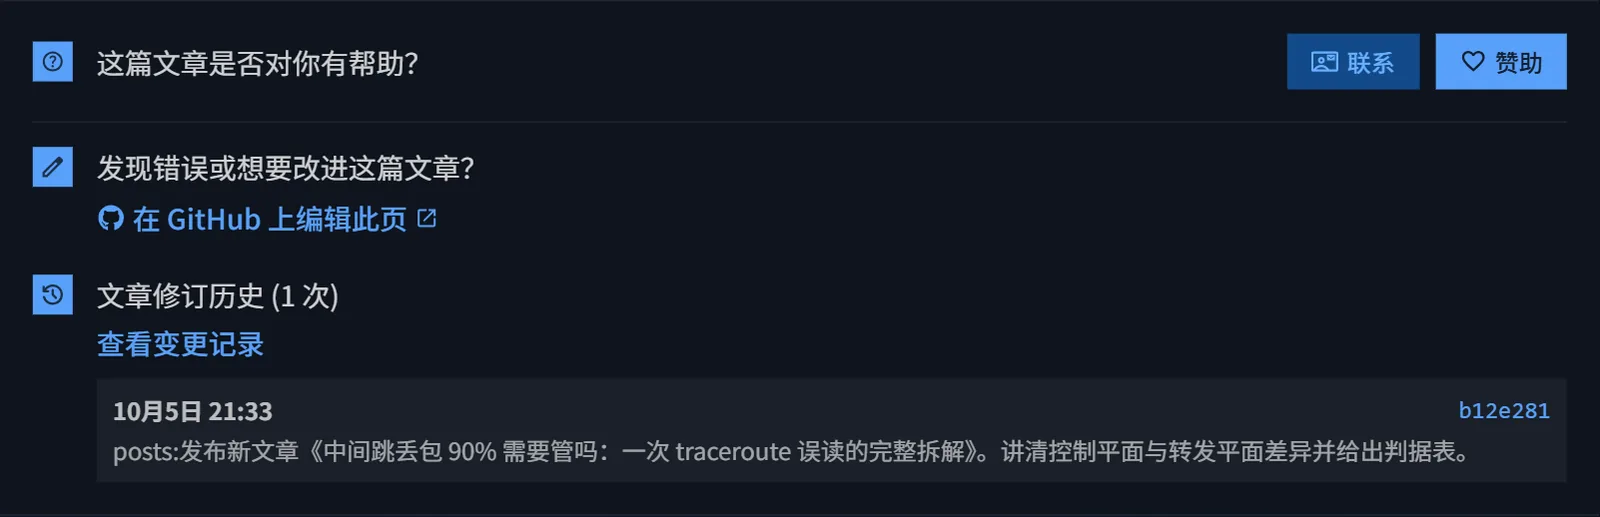
对比第一张图就能看出差别:数据链路一行没改,只换了克隆深度。
五、顺带做的行内 diff 编辑器
摸到「文章版本」这件事之后,我顺手加了一个只在调试时出现的功能:?__diff_debug=1 打开一篇文章,页面左下角会浮出一个面板。面板是单列上下排列的:标题、简介、正文三组字段各自「旧在上、新在下」——DiffDebugEditor.astro 里就是 oldArea 紧接着 newArea 两个 textarea,没有左右对照那一栏。点「保存并生成 DIFF」,差异会直接画在正文上——新增的段落套绿框,被删掉的段落划红线。
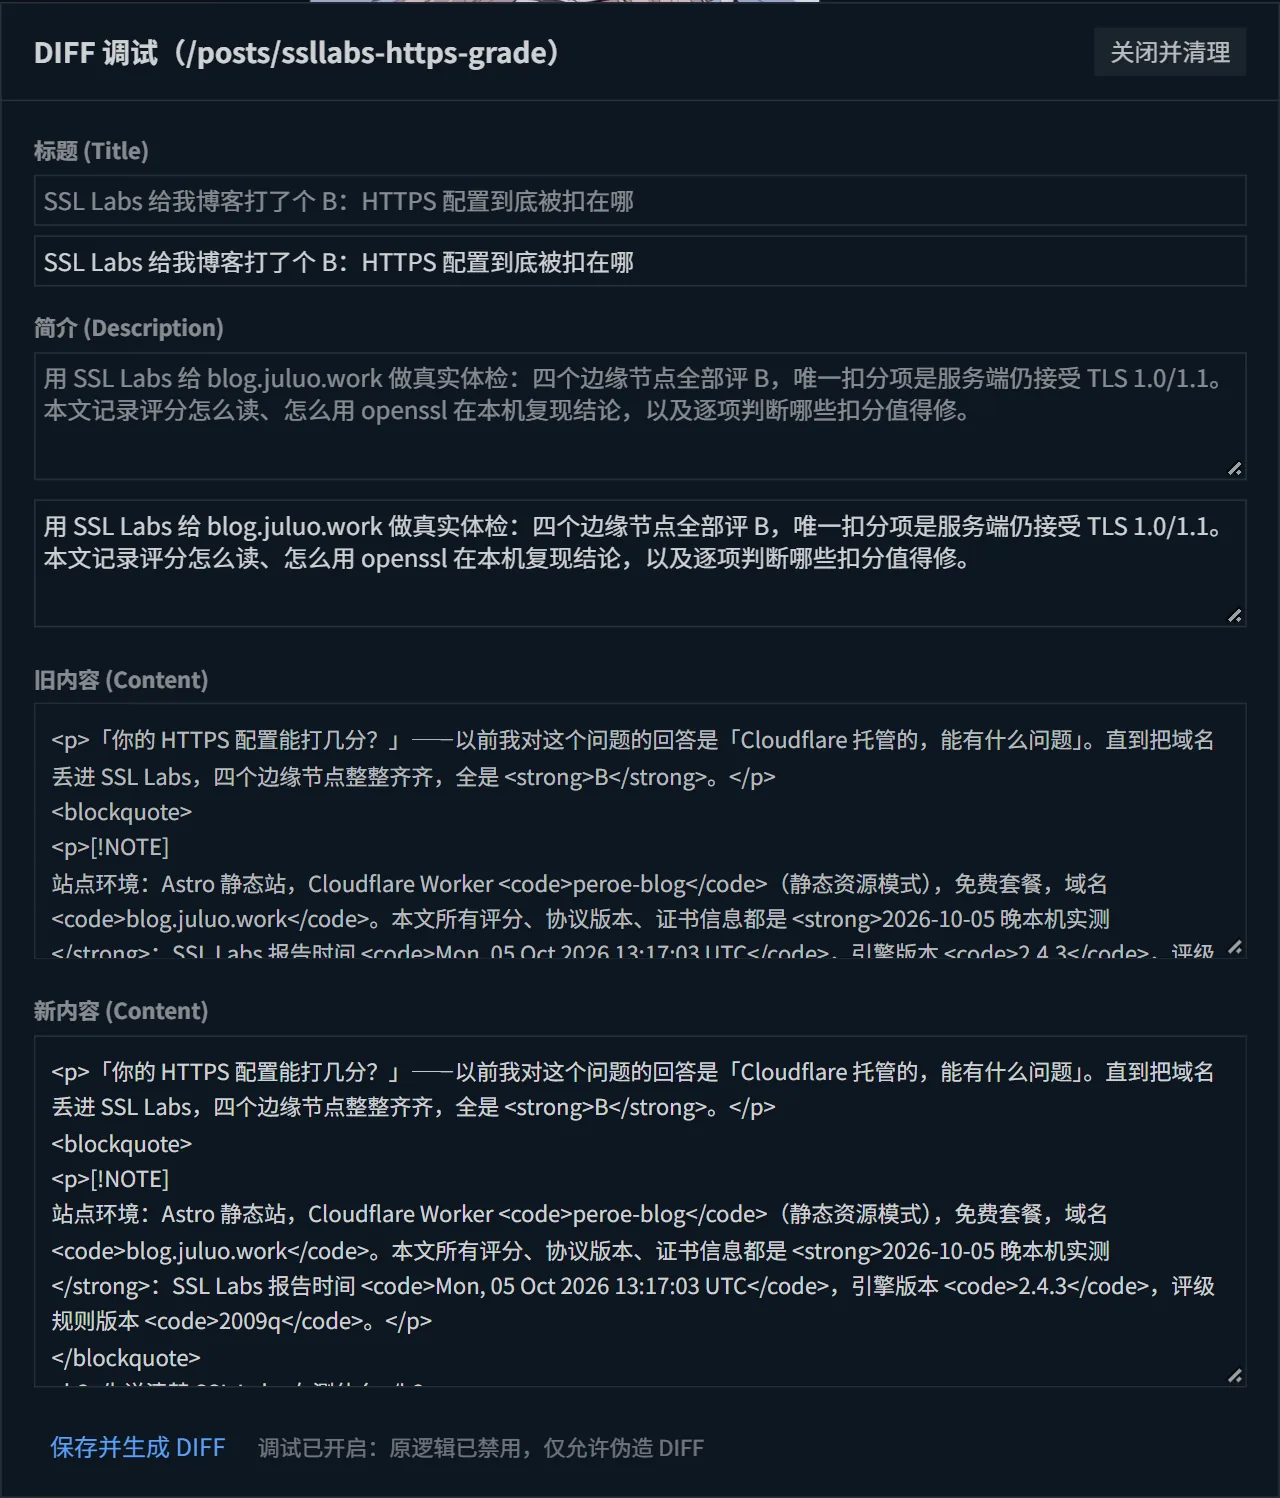
它的数据来源很有意思:旧内容来自 /rss.xml。DiffDebugEditor.astro 会 fetch 当前线上部署的 RSS,从 content:encoded 里取出渲染后的正文 HTML,存进 IndexedDB(fuwari-diff-debug-old)。也就是说,一个本来是给阅读器用的公开 XML,在这里被当成了「线上正文快照」的免费存储——不需要任何服务端接口、不需要额外部署。我实测过:写作时那次部署的 rss.xml 里,当时那 6 篇文章的完整正文都在,一共 101 KB(删掉一篇文章并重新部署之后,这个数会跟着变)。
生成完 diff 之后,结果写进 sessionStorage 的 fuwari-diff-debug-state,再派发一个 fuwari:diff-debug-updated 事件;src/scripts/post-inline-diff.ts 接住事件,把 diff 的每一行拿去和正文里的 p / li / blockquote / pre / h1~h6 做文本比对,找到对应节点再加 class。
取舍要老实讲:
- 匹配是按文本,不是按源码行。我改了措辞、动了标点,旧行在正文里找不到,就只能退化成一整行红色的「已删除」块插在上下文旁边。图里效果好看,前提是「新旧文本大部分能对上」。
- 全局只插一个
#post-diff锚点,多个改动块共用它,所以它只能告诉你「这里变了」,没有 GitHub 那种逐块跳转。 - 成本落在所有读者身上。面板要带参数才显示,但它的脚本是文章页的固定模块。我从线上抓了一下:
DiffDebugEditor...js是 12.5 KB(brotli 传输 4.8 KB),文章页 6 个 JS 模块的 brotli 传输量加起来 34.2 KB——也就是约 14% 的文章页 JS 预算,花在一个绝大多数读者永远不会打开的面板上。 - 还有一个没做完的地方:
post-inline-diff.ts里applyInlineTextDiff和tryApplyInlineReplace两个函数直接return false,全文件也没有任何地方调用它们。字符级的行内 diff(只把改动的那几个字标红)留了位置但没实现,现在是块级效果。
我暂时选择留着这个功能:4.8 KB 换「改完稿立刻看到差异」,对一个月更几篇的个人博客是划算的。但如果哪天文章页 JS 预算变成硬约束,第一个该砍的就是它——把面板改成 ?__diff_debug=1 时再动态 import() 即可,不需要动数据结构。
六、如果你也要做,按这个清单来
- 数据源选 git,前提是克隆深度。
git log --follow是性价比最高的「更新时间线」数据源,但它在构建机上能不能用,取决于克隆深度——这是唯一的前提,也是唯一会静默失败的地方。 - 浅克隆的症状是「所有文章共享同一条最新提交」,不是「历史为空」。看到这个特征基本可以确诊;
git fetch --unshallow是验证和修复都最快的一步。 - 生成物就别进仓库。
git-history.json放.gitignore,让构建前现算;同时接受「构建必须先跑脚本」这个硬约束——静态 import 的报错很明确,比页面悄悄少一块好得多。 - 给键名约定加一道自检。我这套是「相对路径 +
.md」,对不上时函数返回[]、页面静默不渲染。我打算在update-diff.js结尾加一个检查:如果多篇文章拿到同一个哈希、而那篇文章只有一条记录,就让脚本以非零码退出。 - 调试功能要算进所有读者的预算。能用 URL 参数触发的 UI,不代表它的代码不用下载。上线前抓一次产物里的 chunk 大小,心里有数再决定留不留。
如果更关心内容侧怎么变成可检索的产物,站内搜索那篇讲了索引是怎么切出来的。
发现错误或想要改进这篇文章?
在 GitHub 上编辑此页文章修订历史 (1 次)
查看变更记录
docs(baseline): 第 30 轮终检——数字更新到最终状态,补第 28~30 轮小结
相关文章
- 静态博客的站内搜索是怎么做的:一份 JSON 索引加自己写的打分静态站没有后端,站内搜索只能在前端想办法。这篇拆开本站实现:构建期把 Markdown 压成一份 51 KB 的 search.json,浏览器整份拉下来逐字段数命中次数,再按日期排序。附实测的索引体积构成、逐字输入的重取代价与踩过的坑。
- 给静态博客的单篇文章上密码:构建期加密与浏览器解密静态站没有服务端,密码保护只能靠真加密:构建期用 PBKDF2-HMAC-SHA256 派生密钥、AES-256-GCM 加密正文,产物里只剩盐、IV 和密文。这篇讲清参数取舍、公开仓库的明文隔离、元数据泄露清单与解密后要重跑的初始化。
- 构建产物 16 MB,访客每次只下 28 KB统计 dist 目录发现 16 MB、313 个文件,其中 1.6 MB 的 Mermaid 图表引擎从来没被下载过。这篇把「部署体积」与「访客成本」分清:什么进了关键路径、什么按需加载、什么可以被缓存一年。