博客 SEO 自我体检:27 个页面里揪出四个系统性毛病
站点上线三个月,Google 收录了首页和几篇文章,但长尾几乎没动静。与其在 Search Console 里猜,不如把构建产物当成一份可以逐行检查的试卷:我自己写了一支”体检笔”,一次性扫完 27 个页面,然后发现四个毛病全都不是个别页面写歪,而是模板层的系统性缺口。
提示环境:Astro 静态站(
output: "static"),产物在dist/,Node 22 + Python 3.13。 体检脚本用 Python 写,只读 HTML、不依赖第三方库,跑一次不到两秒。
为什么不用现成工具
Lighthouse、PageSpeed Insights、SEO 检测站我全都试过,它们的问题不是不准,而是方向不对:
- 它们盯着单页打分,而模板问题会以”每页都掉一分”的形式出现,看不出共性;
- 它们检查的是普遍规则(有没有 viewport、有没有 HSTS),不关心”这个站的标题是不是一个
<div>”; - 最要命的是依赖线上环境:本地改完还要等部署才能看到结果,来回十几分钟。
而我要回答的问题是:「我这套模板,每一页都合格吗?」这本质上是对构建产物做批处理,写脚本比点按钮快得多。
体检脚本:一张规则表 + 一次遍历
核心就是「读 HTML → 抽字段 → 套阈值 → 打印表格」。规则表是全文的灵魂,我列在下面,你可以按自己站的情况增删:
| 检查项 | 规则 | 为什么 |
|---|---|---|
<title> | 存在,12~48 字 | 中文标题在 SERP 里大约展示 28~30 字,太长会被截断 |
description | 存在,60~160 字,且各页不同 | 全站共用一段描述等于放弃摘要控制权 |
canonical | 存在、绝对地址、指向自身 | 分页和标签页最容易写错 |
<h1> | 恰好 1 个,且非空 | 0 个是丢了主标题语义,多个是主题分散 |
og:image | 存在且可访问 | 分享到群里有没有缩略图全靠它 |
| JSON-LD | 存在且能被 json.loads 解析 | 结构错一个逗号就整段失效 |
<html lang> | 存在 | 中文站最常见的一处遗漏 |
<img alt> | 全部有 | 顺手查的无障碍项 |
| 正文字数 | 工具页/文章页 ≥ 300 字 | 抓”JS 渲染、爬虫看到空壳”的薄内容 |
代码不长,关键只有几行(完整版见文末):
for page in sorted(DIST.rglob("*.html")):
    html = page.read_text(encoding="utf-8", errors="replace")
    html = re.sub(r"(?s)<!--.*?-->", " ", html)      # 注释里的 <title> 会骗过正则
    h1s = re.findall(r"(?is)<h1[^>]*>(.*?)</h1>", html)
    ...
    if len(h1s) != 1:
        issues.append(f"h1 数量 = {len(h1s)}")
小贴士第二行是踩坑换来的:我一开始忘了剥注释,结果 404 页被判成「标题 330 字」—— 因为页面里有一句注释写着
<title>,正则一路吃到真正的</title>。
第一次跑出来的结果
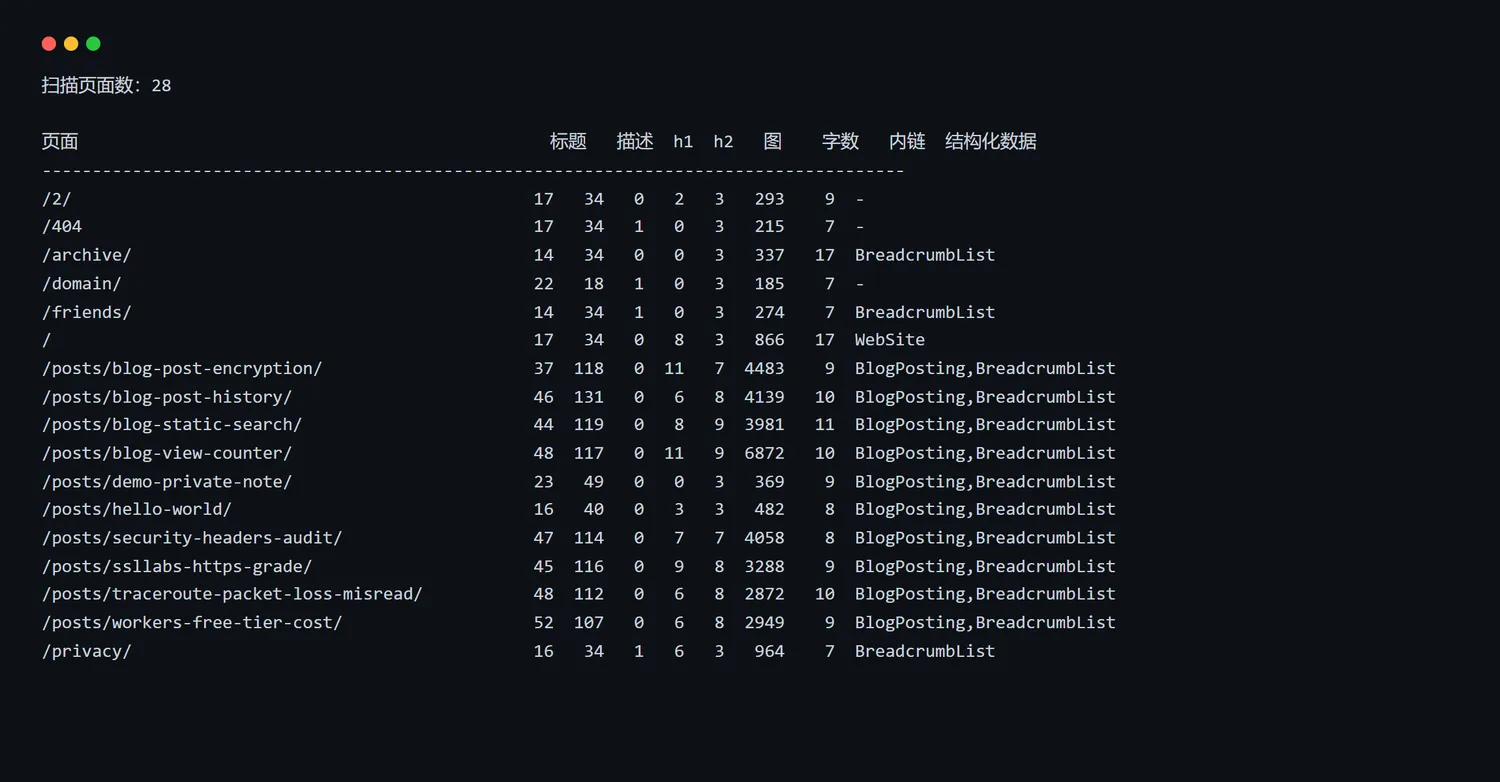
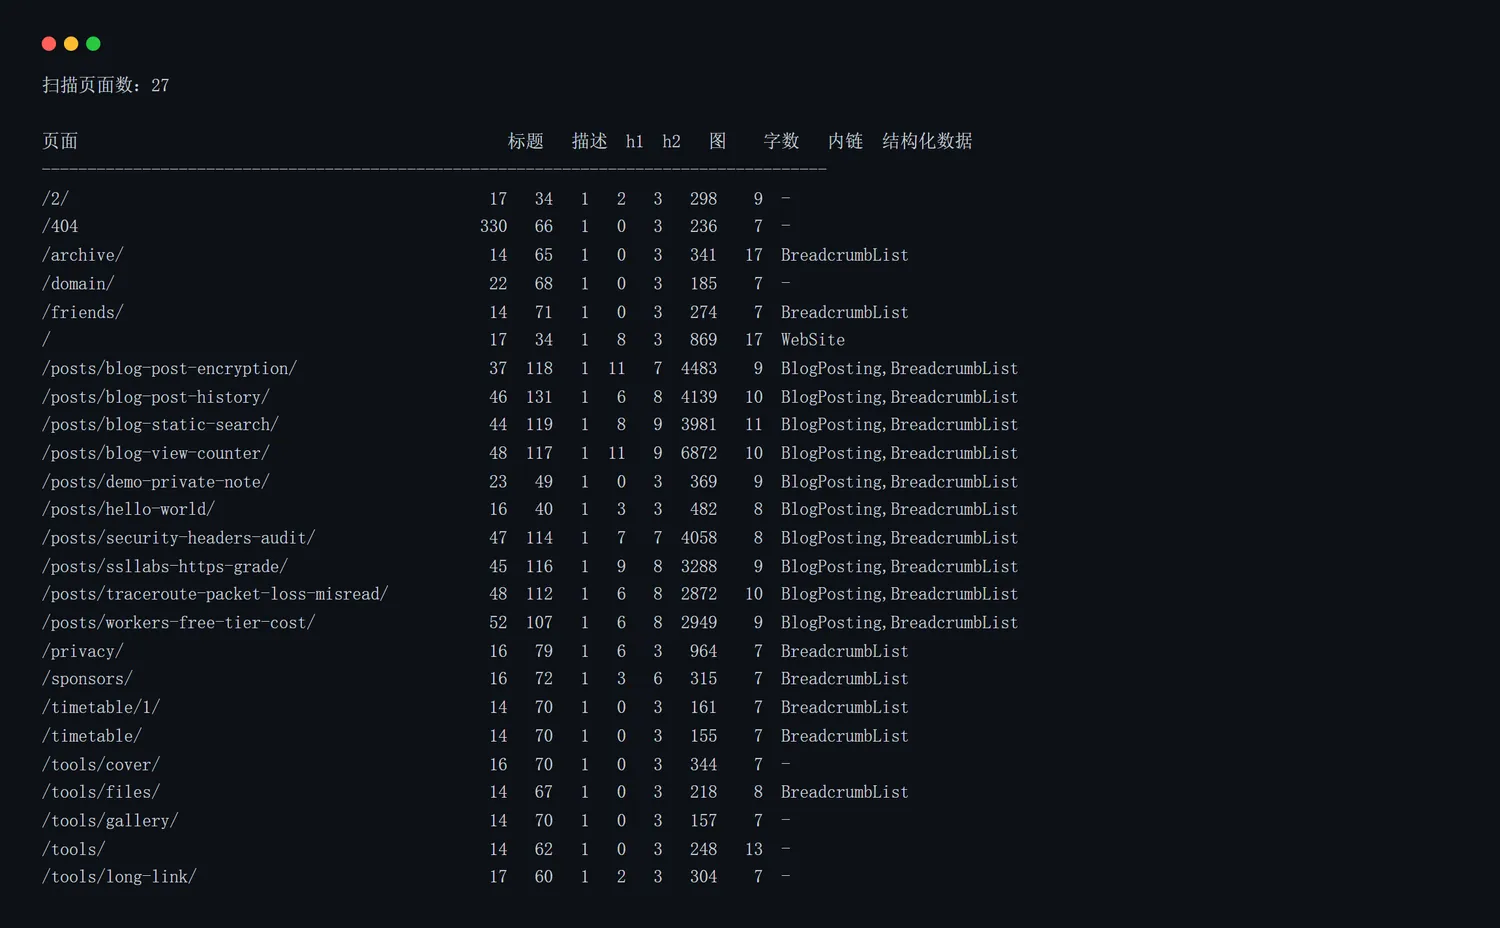
28 个页面,28 个”有问题”。把重复的行合并同类项,其实是四件事:
文章页 h1 = 0        → 9 篇文章 + 首页 + 分页页 + 归档页,一共 12 个页面
全站缺 og:image      → 28 / 28
静态页描述 = 34 字   → 8 个静态页 + 7 个工具页,全是站点默认描述
404 页 head 重复     → 两份 <head>、两个 <title>、两段描述
毛病一:文章标题根本不是 h1
打开文章页源码,标题长这样:
<div id="post-title" class="...text-3xl...">
    <span>博客 SEO 自我体检</span>
</div>
主题作者把标题当成”一段排版好的文字”来写,视觉上完全没问题 —— 字号、粗细、左侧那条主题色竖线都对。但语义上它只是一个 div,搜索引擎读到的文章页没有主标题。
修法是把 div 换成 h1,id 和 class 一个都不动:
-<div id="post-title" class="...">
+<h1 id="post-title" class="...">
     <span>{entry.data.title}</span>
-</div>
+</h1>
这里有个细节值得记:#post-title 被两个脚本按 id 依赖着(行内 diff 高亮、Pagefind 的搜索权重标记),所以只换标签、不换 id,改完这两处逻辑毫发无损。
首页、/2/、/archive/ 是另一类情况:它们本来就没有可见标题(只有文章卡片列表)。硬塞一个大标题会破坏设计,我的做法是给布局加一个 heading 属性,在 <main> 里输出一个 sr-only 的 h1:
{heading && <h1 class="sr-only">{heading}</h1>}
然后首页传「站点名 · 副标题」、分页页传「站点名 · 第 N 页」、归档页传「文章归档」。屏幕阅读器和爬虫都能读到,视觉上零变化。
毛病二:28 个页面都没有分享图
Layout.astro 里原本是这么写的:
{ogImage && <meta property="og:image" content={new URL(ogImage, Astro.site).toString()} />}
逻辑本身没错,问题在于文章 frontmatter 里普遍没有 image 字段 —— 于是 ogImage 永远是 undefined,这行永远不输出。分享到群里,卡片就是纯文字。
修法是给站点做一张默认图,然后无条件输出:
const resolvedOgImage = new URL(ogImage || "/og-default.png", Astro.site).toString();
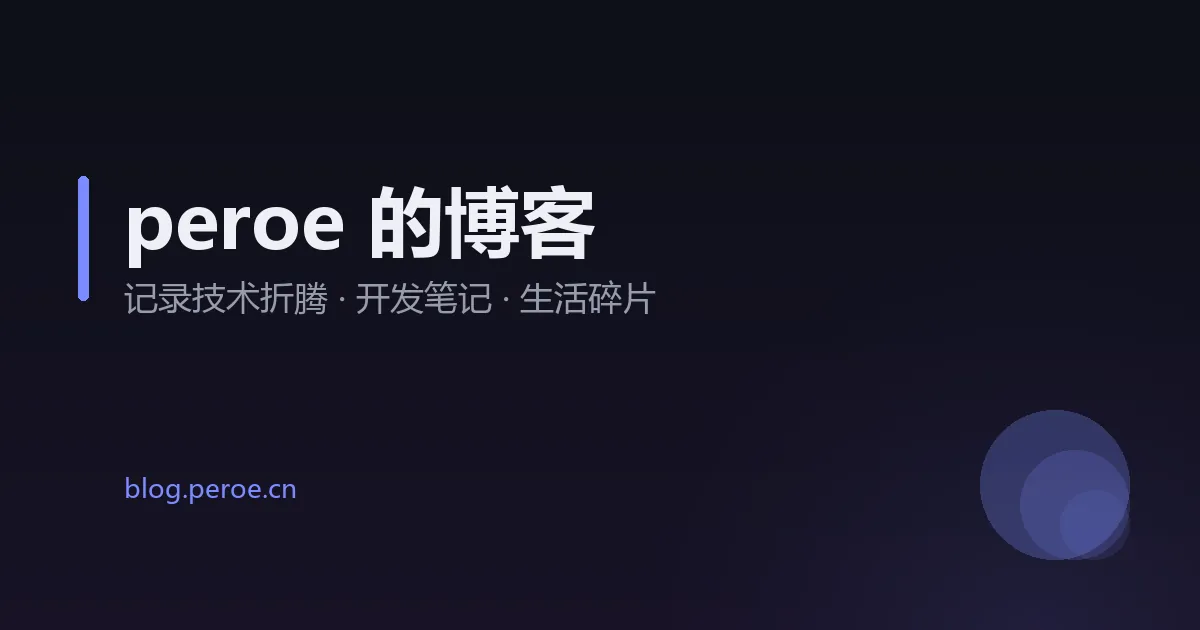
这张图是用 Python + Pillow 画的(1200×630,竖版渐变 + 主题色光晕 + 微软雅黑),35 KB。只有用默认图时才补 og:image:width/height,文章自带封面时就不写死尺寸 —— 免得声明了 1200×630 实际是别的比例。
毛病三:十几个页面共用同一段描述
体检表里那些 34 特别扎眼:所有不传 description 的页面都落到了 siteConfig.description。对搜索引擎来说,这十几个页面的摘要是一模一样的 —— 摘要本该是”这一页讲什么”,不是”这个站讲什么”。
修法很土但有效:给每个页面单独写。14 个页面,全部控制在 60~72 字(中文的 SERP 摘要大约展示 78 字,60 是个安全值):
<MainGridLayout
    title="工具"
    description="peroe 的博客在线工具箱:封面生成、图片画廊、幻影坦克、零宽短链等小工具,全部在浏览器本地运行,不上传数据、不需要登录。"
>
因为文件多,这类机械改动我用 Python 批量做,每处替换都断言「命中数 == 1」:
n = text.count(old)
assert n == 1, f"{rel}: 期望命中 1 处,实际 {n} 处"
没有这条断言,replace 静默不命中时你根本不会发现 —— 这项检查在本次改 23 处时救了我两次(有两处字符串写错了一个空格)。
毛病四:404 页输出了两份 head
体检表里 /404 那一行 description 是 34 字,可我明明给它写了描述。翻构建产物才发现页面里有两份 <head>:
<html><head>...<title>页面未找到 - peroe 的博客</title>
       <meta name="description" content="(站点默认描述)">
...<!----><html><head><title>页面不存在 - peroe 的博客</title>...
原因是 404 页这么写的:
<Layout title="页面未找到">          <!-- 外层已经套了一个 Layout -->
    <MainGridLayout title="页面不存在">  <!-- 这里面又包含一个 Layout -->
MainGridLayout 内部本身就包了 Layout,再套一层就成了「Layout 里套 Layout」——整份文档被渲染两遍,浏览器能容错,爬虫只会困惑。删掉外层那层就干净了。
警告这类错误不会报错、不会白屏,只有把产物当文本看才会暴露。所以体检脚本必须扫
dist/,而不是看浏览器里”页面能用”。
附带发现:薄内容工具页
体检表还标了两行字数:/tools/gallery/ 只有 105 字、/tools/files/ 只有 166 字。这两页的功能都是脚本渲染的(画廊靠 JS 拉图、文件列表靠 JS 渲染),爬虫来的时候看到一个空壳。
处理方式不是 noindex(这些页是有用的入口),而是补服务端渲染的正文:讲清楚这些图/文件从哪来、为什么不放第三方图床、下载前要注意什么。
复查:从 28 降到 12
剩下 12 条基本是”可以接受但能更好”的:工具页还没加 WebApplication 结构化数据、两篇演示文章的描述偏短、首页用的是站点描述(它本来就是站点首页,合理)。这类留在待办里,不再算问题。
顺手一提:站点地图曾经整整四天没被收录
体检顺带治好了另一个老毛病:Search Console 一直报「无法抓取」,而同一台服务器上的 rss.xml 却是「成功」。
真正的报错在详情页里(列表页只写”无法抓取”,点进去才看到「无法读取此站点地图」)。拿官方 sitemap.xsd 一校验,立刻现形:
Element 'changefreq': This element is not expected.
第一条 <url> 的子元素顺序: loc → priority → changefreq
官方 XSD 里 <url> 是 <xsd:sequence>,顺序必须固定为 loc → lastmod → changefreq → priority。我当初是按”看着顺眼”排的,XML 依然 well-formed,Bing 也照样认,只有严格按 XSD 校验的 Google 会拒收。
修完之后我在生成函数里加了一道自检:逐条 <url> 校验子元素顺序,不符就在构建日志里告警 —— 这种”静默失败”必须让构建期替人盯着。
一份可以照抄的体检清单
如果你也是静态站,把下面这张表对着自己的模板过一遍,八成能拣到几条:
- 每个页面恰好一个 h1,且 h1 不是 logo 也不是站点名(列表页例外,可以用 sr-only);
og:image一定要有兜底,别指望每篇文章都配封面;- 描述逐页写,别全站共用 —— 这十几段文字是唯一能控制的摘要;
- 警惕嵌套布局:一个页面里出现两个
<title>,就是套了两层 Layout; - 功能页要有服务端可见的正文,纯 JS 渲染的页面在爬虫眼里是空的;
- XML 产物要按 schema 校验,well-formed ≠ 符合 XSD;
- 改完重新扫一遍,把”改好了”变成表格里的一个数字,而不是一句自我感觉。
小结
这四个毛病的共同点:它们都不影响”人能看见的页面”。h1 变成 div、描述复用、head 重复、正文靠 JS —— 浏览器里一切正常,所以永远等不到”有人报错”。
SEO 的日常因此更像定期体检而不是”修 bug”:写一支便宜的脚本、定一张规则表、每次改完模板跑一遍。这套流程两秒钟一次,比在站长后台等四天要划算得多。
体检脚本我已经放进了本地工具目录(seo-audit.py),下一轮维护时直接复跑;等文章攒多一些,再补 WebApplication、Article 的多语言字段和 sameAs 之类的细节。
体检里的性能部分单独写过一篇:首屏从 392KB 砍到 59KB。
把标签变成聚合页面的那次改造写在静态站的标签体系里。
这套体检的八项判据、九类真实问题与三条教训,后来单独整理成了一份可复跑的清单。
站内搜索是怎么做索引的,也单独写过:27 篇文章的站内搜索。
发现错误或想要改进这篇文章?
在 GitHub 上编辑此页文章修订历史 (1 次)
查看变更记录
docs(baseline): 第 30 轮终检——数字更新到最终状态,补第 28~30 轮小结
相关文章
- 静态站的标签体系:挖出 11 个可收录页面23 篇文章、20 个标签,但页面上一个标签都看不到——前端组件把 tags 静默忽略了。这篇记录怎么把标签变成 11 个可收录页面(10 个标签落地页 + 索引),以及中文标签在 Astro 里踩到的三个坑。
- 首屏从 392KB 砍到 59KB,FCP 从 7.4 秒到 2.1 秒用 CDP 模拟中端手机实测博客首页:GA4 与 Clarity 挤在关键路径、头像和 favicon 直接加载 107KB 原图、312KB 关键 CSS 拖慢首屏。四处改动后传输 392KB→59KB,FCP 7.4s→2.1s,长任务 13→2 个。
- 24 篇文章的站内 SEO:一套可复跑的体检清单不靠站长后台、不装插件,写一个脚本扫构建产物就能查出大部分站内 SEO 问题。这篇是 24 篇文章、54 个页面跑下来整理出的八项检查、九类真实问题与修法,以及三条「体检本身也会骗你」的教训。