24 篇文章的站内 SEO:一套可复跑的体检清单
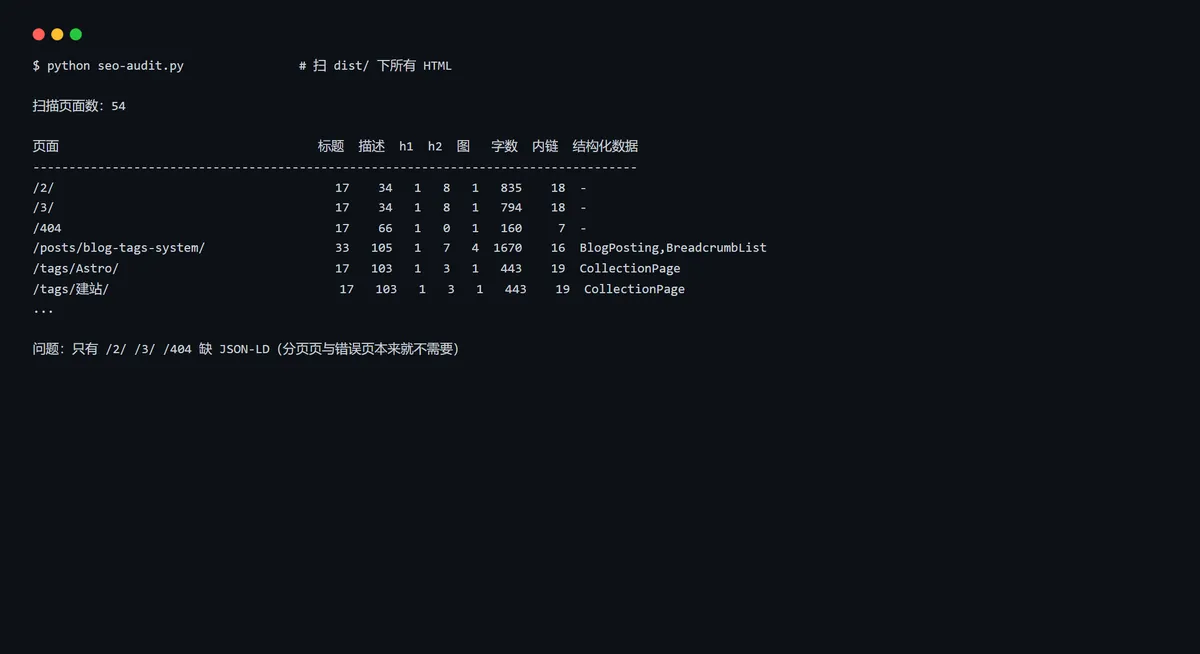
站内 SEO 的问题大多不需要登录任何后台就能发现:构建产物里的 HTML 就是事实。标题多长、描述是不是重复、h1 有几个、canonical 指向哪、结构化数据能不能解析——全都在 dist/ 里。
我给这个博客写了个体检脚本,24 轮下来跑了上百次。这篇把检查项、真实问题与修法整理成一份可以照抄的清单。
八项检查,扫的就是产物
| 检查 | 判据 |
|---|---|
| title | 12~48 字(含站点后缀),且非空 |
| description | 60~160 字,每页唯一 |
| canonical | 存在、绝对地址、指向自身(中文路径要按语义比,下面会讲) |
| h1 | 恰好 1 个,且非空 |
og:image | 存在(分享卡片靠它) |
| 结构化数据 | 能被 JSON.parse 解析 |
| 正文厚度 | 少于 300 字标「偏薄」 |
| 内链 | 统计站内出链数,配合另一个脚本算入链与孤岛 |
实现只有一百多行:用 glob 遍历 dist/**/*.html,正则取 <head> 里的标签,用一个小型 HTML 解析器数 h1/h2/<img>,再对 JSON-LD 做一次 JSON.parse。
关键前提:先删 dist/。Astro 构建不会清理上一次的产物,我因此扫到过一个线上早已 404 的幽灵页面(/t/),还据此下了一堆错误结论。
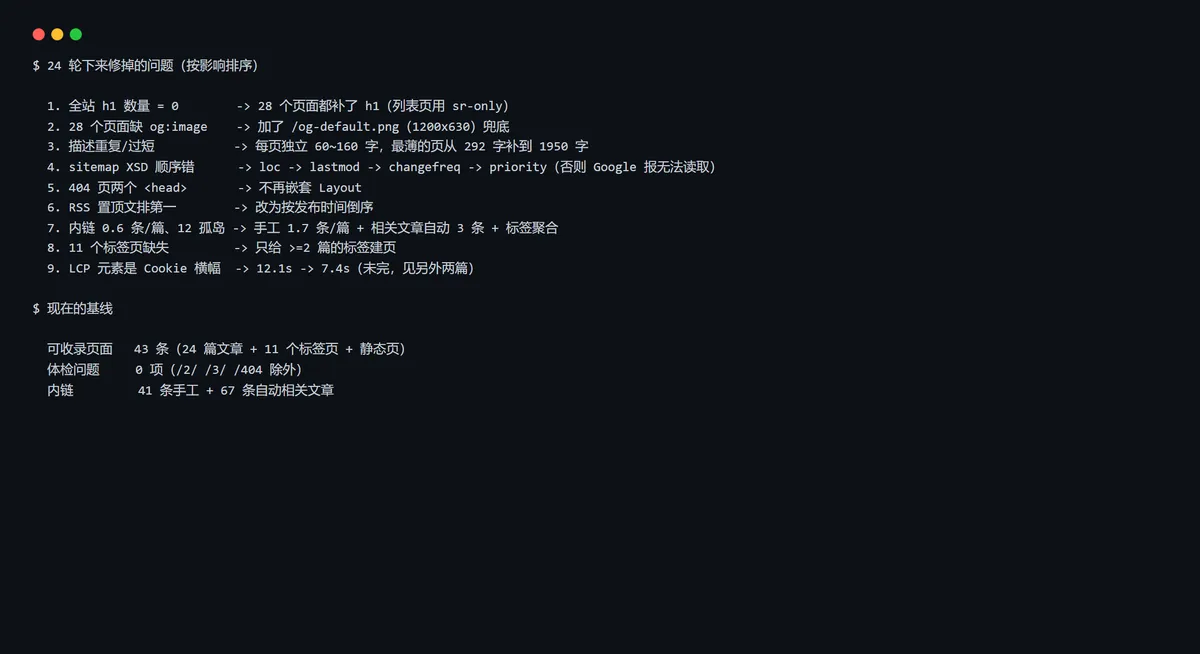
九类真实问题(按影响排序)
| 问题 | 规模 | 修法 |
|---|---|---|
| 全站 h1 数量 = 0 | 28 个页面 | 布局加 heading 属性渲染 <h1 class="sr-only">;文章页的 div#post-title 改成 h1 |
28 个页面缺 og:image | 全部列表页 | 生成 /og-default.png 兜底,布局里统一输出 og:image + width/height |
| 描述重复或过短 | 十几个页面 | 每页独立描述;最薄的两个工具页从 292 字补到 1950 字 |
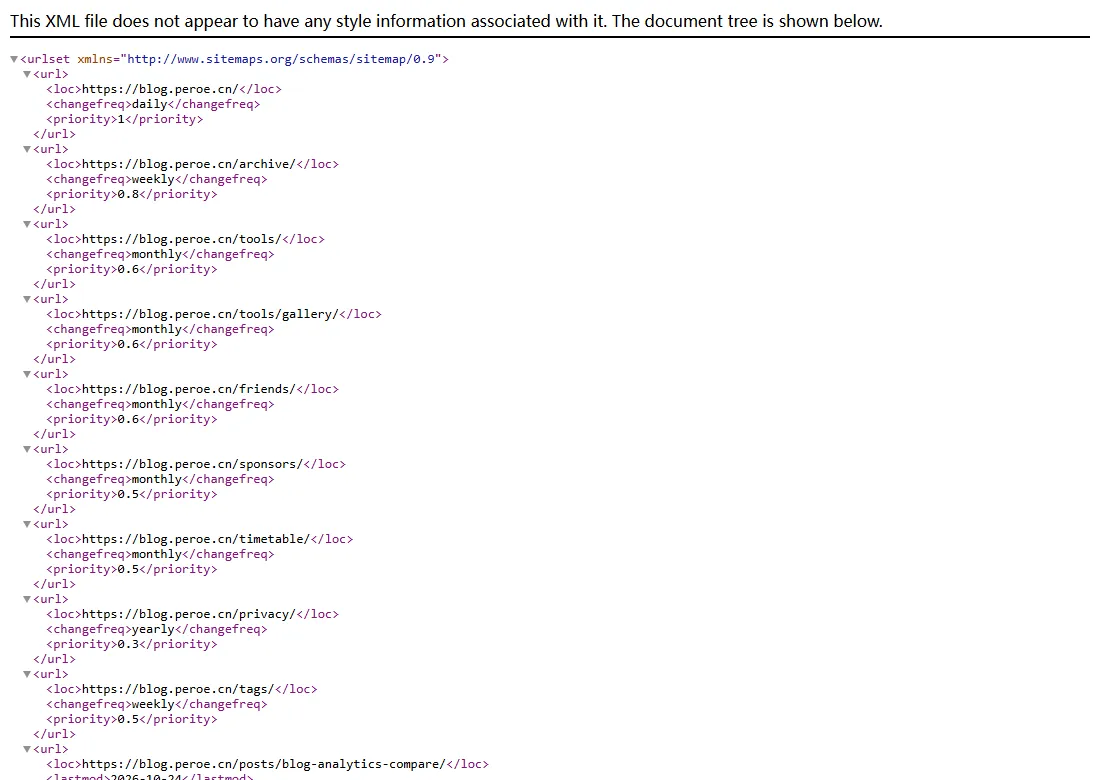
| sitemap 的 XSD 顺序错 | 2 条 sitemap | 必须 loc → lastmod → changefreq → priority,否则 Google 报「无法读取此站点地图」 |
404 页输出两个 <head> | 1 页 | 不要再把 MainGridLayout 嵌进 Layout |
| RSS 里置顶文排第一 | 全站 feed | 改成按 published 倒序(列表页仍保持置顶优先) |
| 内链太稀、孤岛多 | 12 篇零入链 | 手工补上下文链接 + 「相关文章」自动生成 + 标签聚合页 |
| 11 个标签页缺失 | 20 个标签 | 只给 ≥2 篇文章的标签建页(单篇标签是薄内容) |
| LCP 元素是 Cookie 横幅 | 全站 | 提前加载 + 压缩体积(12.1s → 7.4s,未完) |
前两项最典型:问题不在某篇文章,而在模板。h1 = 0 意味着所有页面的标题层级都是坏的,搜索引擎只能自己猜哪个是主题。
现在的基线
扫描页面    54 个(24 篇文章 + 11 个标签页 + 静态页 + 分页)
可收录     43 条(sitemap)
体检问题   0 项(只有 /2/ /3/ /404 缺 JSON-LD —— 分页与错误页本来就不需要)
内链       41 条手工 + 67 条自动相关文章
三条「体检本身也会骗你」的教训
1. 脚本的隐含条件要写下来。
我的性能脚本带了一行 --host-resolver-rules=MAP * ~NOTFOUND(当初为了绕开本机代理),副作用是把所有第三方域名都解析失败——于是长期报出「LCP 1.9 秒」,而真实现场是 12 秒。任何”隐含条件”都要在脚本头部写清楚,否则半年后的你会被自己骗。
2. URL 要按语义比,不能按字符比。
中文标签页 /tags/统计/ 的 canonical 是 percent-encoded 形式,逐字符比较会报 10 条假问题。比较前 unquote() 两边。
3. 同一套规则要在多处保持一致。
标签页的建页条件是「≥2 篇文章」,这个条件同时出现在三处:getStaticPaths(决定生成哪些页)、PostMeta(决定哪些标签可点)、sitemap(决定收录哪些 URL)。任何一处漏掉,结果不是 404 就是孤儿页。
怎么复跑
rm -rf dist && pnpm astro build --force     # 干净构建
python seo-audit.py                        # 八项检查
python link-audit.py                       # 入链/出链/孤岛
两个脚本都在我的本地工具目录里、不进仓库——它们不含任何站点私有信息,但也没必要让仓库多两个 Python 文件。
小结
站内 SEO 没什么神秘:把「什么样的页面算合格」写成可执行的判断,然后每次都跑一遍。
真正花时间的是修——尤其是那些”问题在模板里、影响全部页面”的项。但正因为它们在模板里,修一次就永久生效:h1、og:image、canonical 这三件事修完之后,后面每发一篇文章都自动合规。
体检之后更麻烦的是性能:LCP 元素居然是 Cookie 横幅,两次尝试的过程写在和 Cookie 横幅抢 LCP里。
体检不止有 SEO 一种:键盘焦点、对比度、无障碍名称也值得查一遍,过程见可访问性体检。
发现错误或想要改进这篇文章?
在 GitHub 上编辑此页文章修订历史 (1 次)
查看变更记录
docs(baseline): 第 30 轮终检——数字更新到最终状态,补第 28~30 轮小结
相关文章
- 可访问性体检:三个真问题与三次假警报用脚本给自己的静态博客做了一次可访问性体检:重复 id、搜索框没有无障碍名称、键盘焦点环在深色背景上几乎看不见。同时记录体检脚本自己报过的三次假警报——它们比漏报更危险。
- 构建产物 16 MB,访客每次只下 28 KB统计 dist 目录发现 16 MB、313 个文件,其中 1.6 MB 的 Mermaid 图表引擎从来没被下载过。这篇把「部署体积」与「访客成本」分清:什么进了关键路径、什么按需加载、什么可以被缓存一年。
- 博客 SEO 自我体检:27 个页面里揪出四个系统性毛病不靠站长后台,直接扫构建产物做 SEO 体检:发现全站 h1 数量为 0、28 个页面都没有 og:image、静态页共用同一段描述、404 页输出了两份 head。附体检清单与修法。