中间跳丢包 90% 需要管吗:一次 traceroute 误读的完整拆解
上一篇给博客做全国 Ping 体检测出:Cloudflare 免费套餐在国内访问平均 233ms。这次我想知道得更细一点——这 200 多毫秒,到底花在路径上的哪些路由器了?
于是我在 tcptest.cn 上跑了一次从福建泉州电信到 blog.juluo.work 的在线路由追踪。结果第一眼挺吓人:中间连续几跳的丢包率是 99%、87%、97%。
只看这三个数字,结论应该是”电信骨干网崩了”。可博客当时打开得好好的,多节点 Tcping 也显示 443 端口正常(数据见上一篇)。
提示本文数据均为 2026-10-05 晚实测:多节点数据来自 tcptest.cn 的在线路由追踪(福建泉州电信节点,每跳 100 个探测包);本机数据来自 Windows 上的
tracert、ping和一段 TCP 连接测试脚本。所有截图都来自真实执行结果。
那张追踪表到底显示了什么
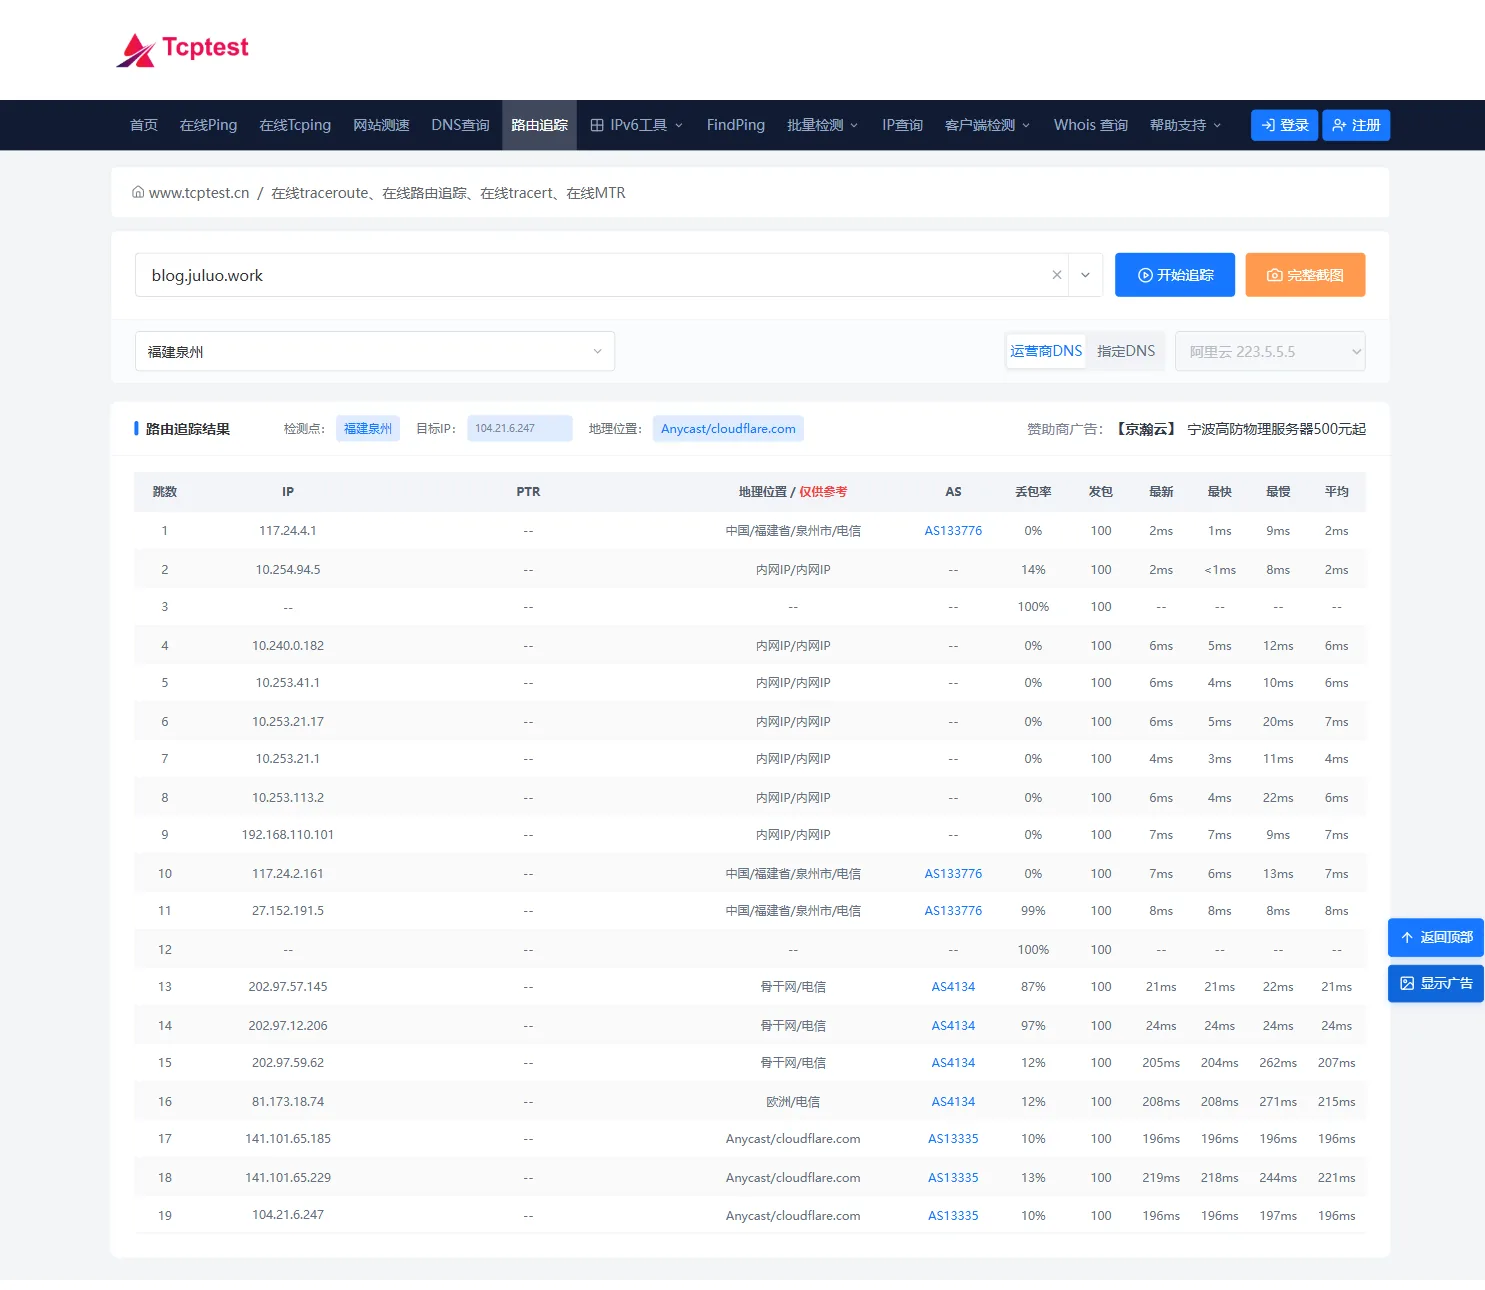
把关键几跳摘出来(丢包率一列是按 100 个探测包统计的):
| 跳 | IP | 归属 | 丢包率 | 平均延迟 |
|---|---|---|---|---|
| 1 | 117.24.4.1 | 中国福建泉州/电信 | 0% | 2ms |
| 2 | 10.254.94.5 | 运营商内网 | 14% | 2ms |
| 3 | — | — | 100% | — |
| 10 | 117.24.2.161 | 泉州电信 AS133776 | 0% | 7ms |
| 11 | 27.152.191.5 | 泉州电信 AS133776 | 99% | 8ms |
| 12 | — | — | 100% | — |
| 13 | 202.97.57.145 | 骨干网/电信 AS4134 | 87% | 21ms |
| 14 | 202.97.12.206 | 骨干网/电信 AS4134 | 97% | 24ms |
| 15 | 202.97.59.62 | 骨干网/电信 AS4134 | 12% | 207ms |
| 16 | 81.173.18.74 | 欧洲/电信 AS4134 | 12% | 215ms |
| 19 | 104.21.6.247 | Cloudflare AS13335(目标) | 10% | 196ms |
这张表里有三处”自相矛盾”的地方,正是它们救了这次判断:
- 丢包 99% 的那一跳,延迟反而特别漂亮。第 11 跳最快 8ms、最慢 8ms、平均 8ms;第 14 跳更整齐,四个值全是 24ms。链路真丢包时伴随的是排队和延迟抖动,不会是”漏回来的包一个比一个准时”。
- 第 12 跳 100% 丢包,可第 13、14 跳还在回话。如果路径真在第 12 跳断了,后面的跳不可能有回包。100% 只代表”这台设备压根不打算理你”。
- 末跳只丢 10%。第 19 跳的 IP
104.21.6.247就是目标本身,它丢 10%、平均 196ms——站点是通的。
真正值得留意的其实是第 15 跳:延迟从 24ms 一步跳到 207ms,而且是离开电信骨干网(AS4134)之后。这不是丢包,是出境绕路——报文从泉州走到电信国际出口,再绕经电信的境外节点(表里标注为”欧洲/电信”,地理位置仅供参考),最后交给 Cloudflare 的 Anycast 边缘。上一篇测到的”全国平均 233ms”就是这么来的:绕路,而不是链路损坏。
为什么中间跳会”丢包”:控制平面 vs 转发平面
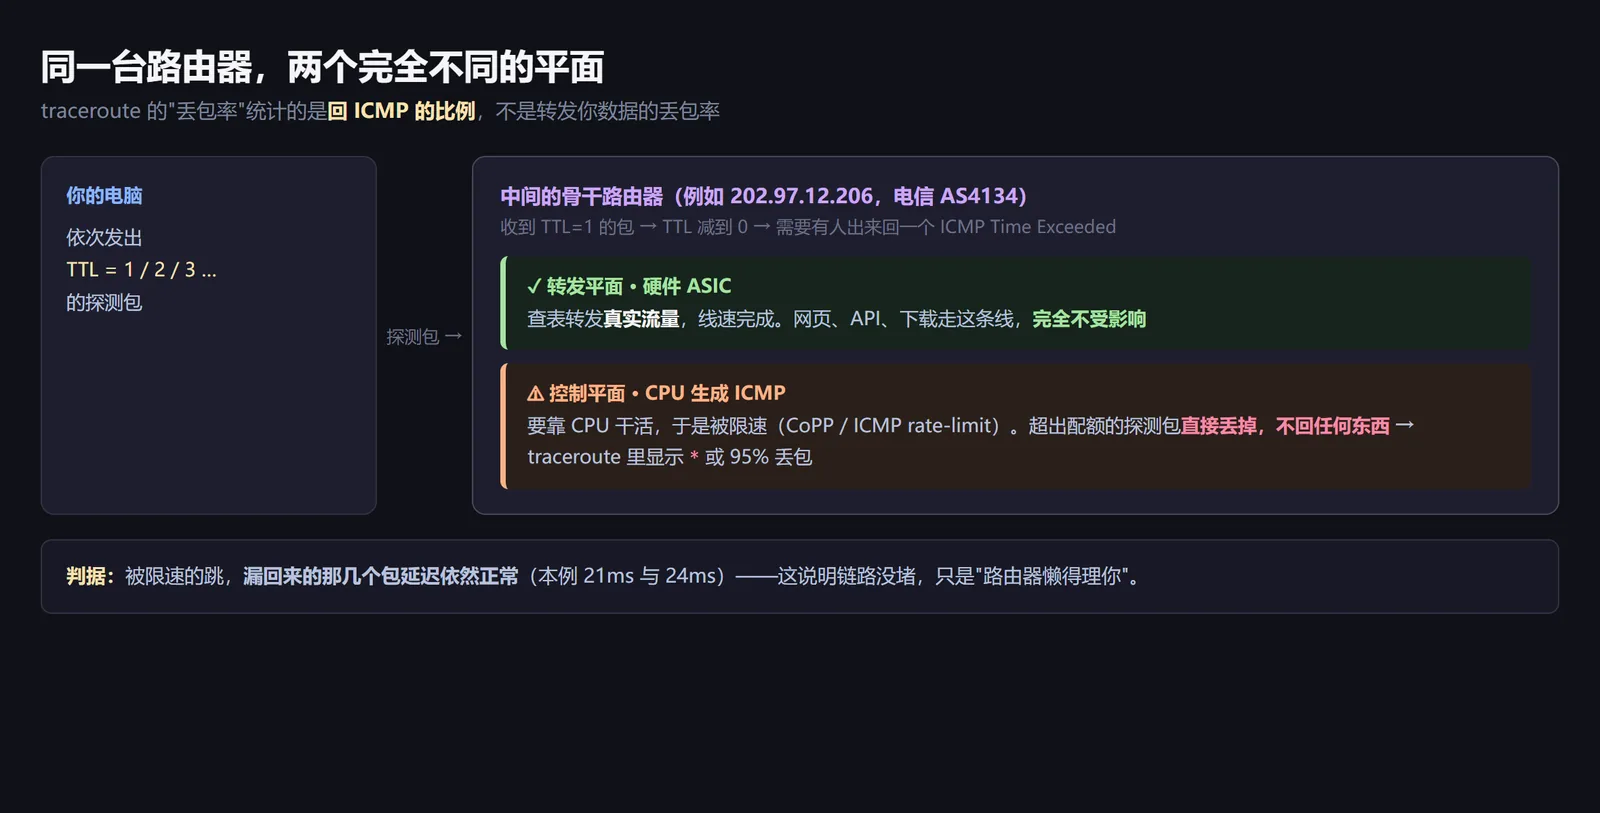
要读懂这些数字,得先接受一个事实:路由器不是一台电脑,它至少有两套干活的方式。
- 转发平面(Forwarding Plane):拆包头、查路由表、把包从某个口扔出去。这件事由专用芯片(ASIC / NP)完成,线速运行,你的网页请求、API 调用、视频流全走这条路。
- 控制平面(Control Plane):跑路由协议、维护转发表,以及处理各种”需要 CPU 想一想”的杂事。生成 ICMP 错误报文,就属于这一类。
traceroute 的原理是发出 TTL 依次为 1、2、3… 的探测包,逼路径上第 N 台路由器把 TTL 减到 0,然后由它生成一个 ICMP Time Exceeded 报文(RFC 792 定义)回给你。关键在于:这个 ICMP 属于”额外劳动”,和转发你的数据没有任何关系。
而一台骨干路由器面对的是整个互联网。全世界每时每刻都有人在探测它,如果它对每个 TTL 超时的包都老老实实生成 ICMP,CPU 会被这种毫无价值的活打满。所以运营商和设备厂商的通行做法是给 ICMP 生成限速:Cisco 上有 ip icmp rate-limit unreachable 这类命令,运营商侧普遍部署 CoPP(Control Plane Policing)策略;IETF 的 ICMP 过滤建议 也把”限速”列为推荐手段。
结果就是:traceroute 里的”丢包率”,统计的是这台路由器愿意回 ICMP 的比例,而不是它转发你数据时丢包的比例。 第 11 跳的 99% 只是说”100 个探测包它只回了 1 个”;第 14 跳的 97% 也只是说”它只回了 3 个”。
区分限速和真丢包,最省事的办法是看被限速那一跳漏回来的包的延迟:
- 控制平面限速:漏回来的包延迟低且稳(本例 8ms / 21ms / 24ms,最快最慢几乎一样)。因为链路根本不堵,只是路由器懒得理你。
- 真拥塞:延迟明显抬高,而且最快 / 最慢 / 平均三个值会拉开很大差距——排队是随机的。
我自己电脑上那次更离谱的误读
讲完别人的数据,说说我在自己机器上踩的坑。为了给这篇文章配一张本机 tracert 的图,我在 Windows 上跑了:
tracert -d blog.juluo.work
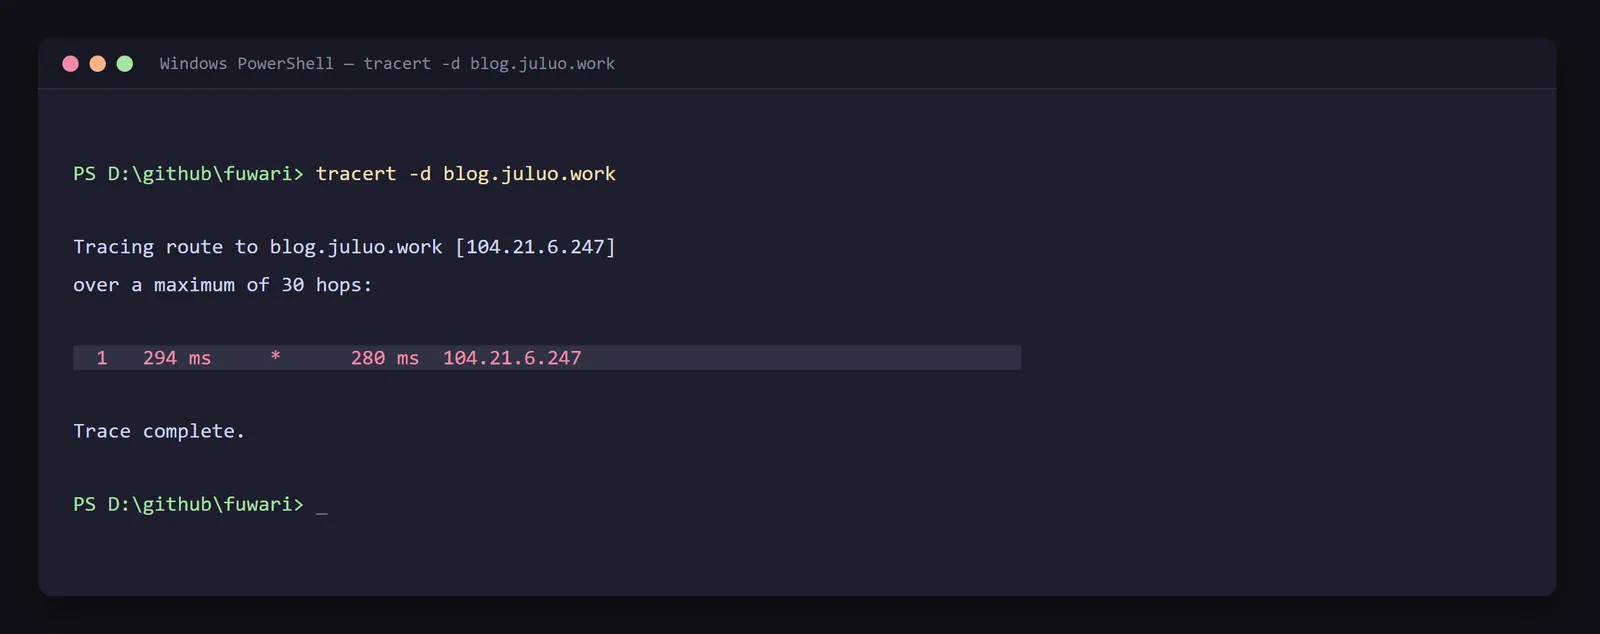
只出来一跳,而且第一跳就是目标 IP。
换 tracert -d 8.8.8.8、tracert -d www.baidu.com,一样只有一跳。原因不在运营商,在我自己机器上:我开着 TUN 模式的代理,route print -4 里两条默认路由,走 TUN 网卡(198.18.0.0/15 那段,metric 0)的那条优先级更高,所有流量——包括 ICMP 探测包——都在本地被代理栈接管了。测量点在代理里面,测出来的自然不是真实路径。
顺手做的另外两个测试同样不可信:
ping -n 20 blog.juluo.work
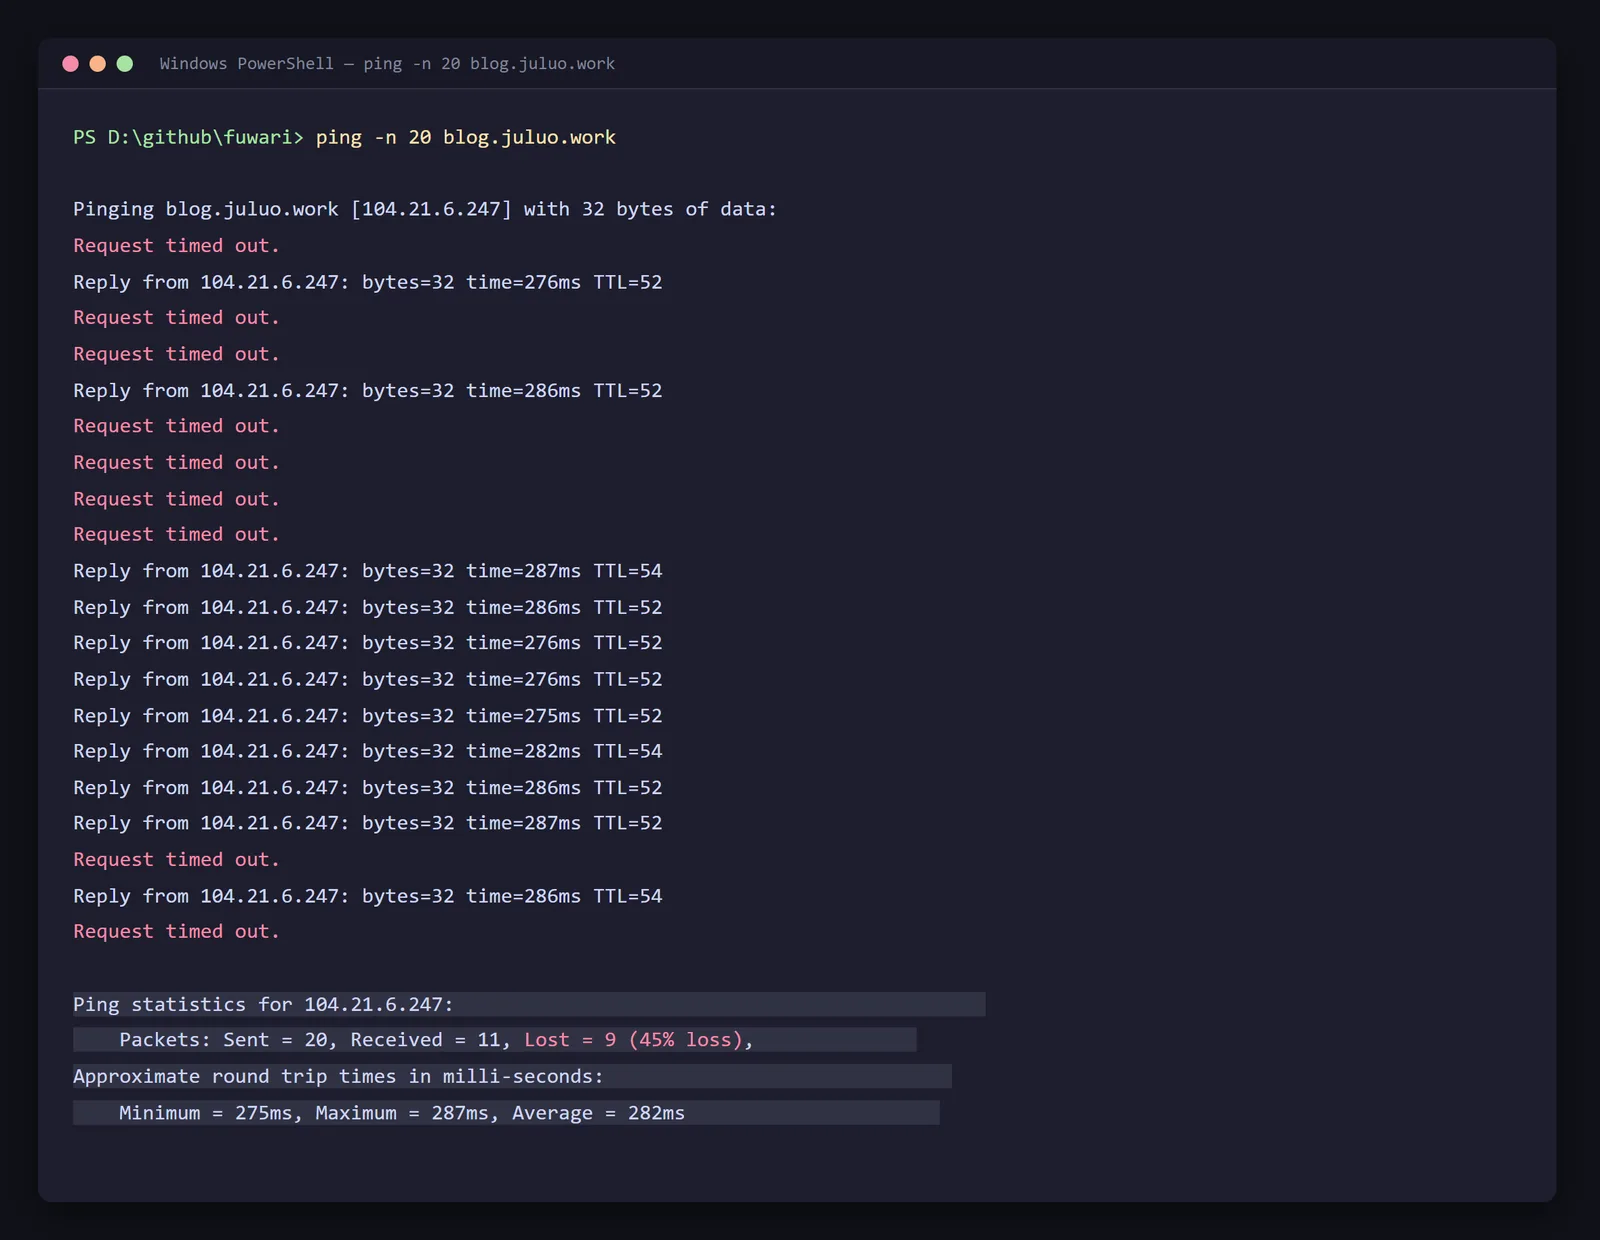
20 个包丢 9 个,45% 丢包。拿着这张图去问人,大概率会得到”你的服务器在丢包”的答案。但看仔细一点:成功的 11 个包,最快 275ms、最慢 287ms,极差只有 12ms。这种”丢得厉害、延迟却极其稳定”的组合,和前面第 11 跳是同一类现象——限速,而不是拥塞。
最能说明问题的是第三个测试。我写了个二十来行的 Python 脚本,对 blog.juluo.work:443 连续建立 20 次 TCP 连接:
import socket
import statistics
import time

HOST = "blog.juluo.work"
PORT = 443
N = 20

ok = 0
times = []
for i in range(1, N + 1):
    s = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    s.settimeout(5)
    t0 = time.perf_counter()
    try:
        s.connect((HOST, PORT))          # 只做三次握手,不发业务数据
        dt = (time.perf_counter() - t0) * 1000
        times.append(dt)
        ok += 1
        print(f"{i:2d}  TCP {PORT} connect OK   {dt:7.1f} ms")
    except Exception as e:
        print(f"{i:2d}  TCP {PORT} connect FAIL {e}")
    finally:
        s.close()
    time.sleep(0.2)

print(f"\nsuccess = {ok}/{N}, failed = {N - ok}")
print(f"min = {min(times):.1f} ms, avg = {statistics.mean(times):.1f} ms, max = {max(times):.1f} ms")
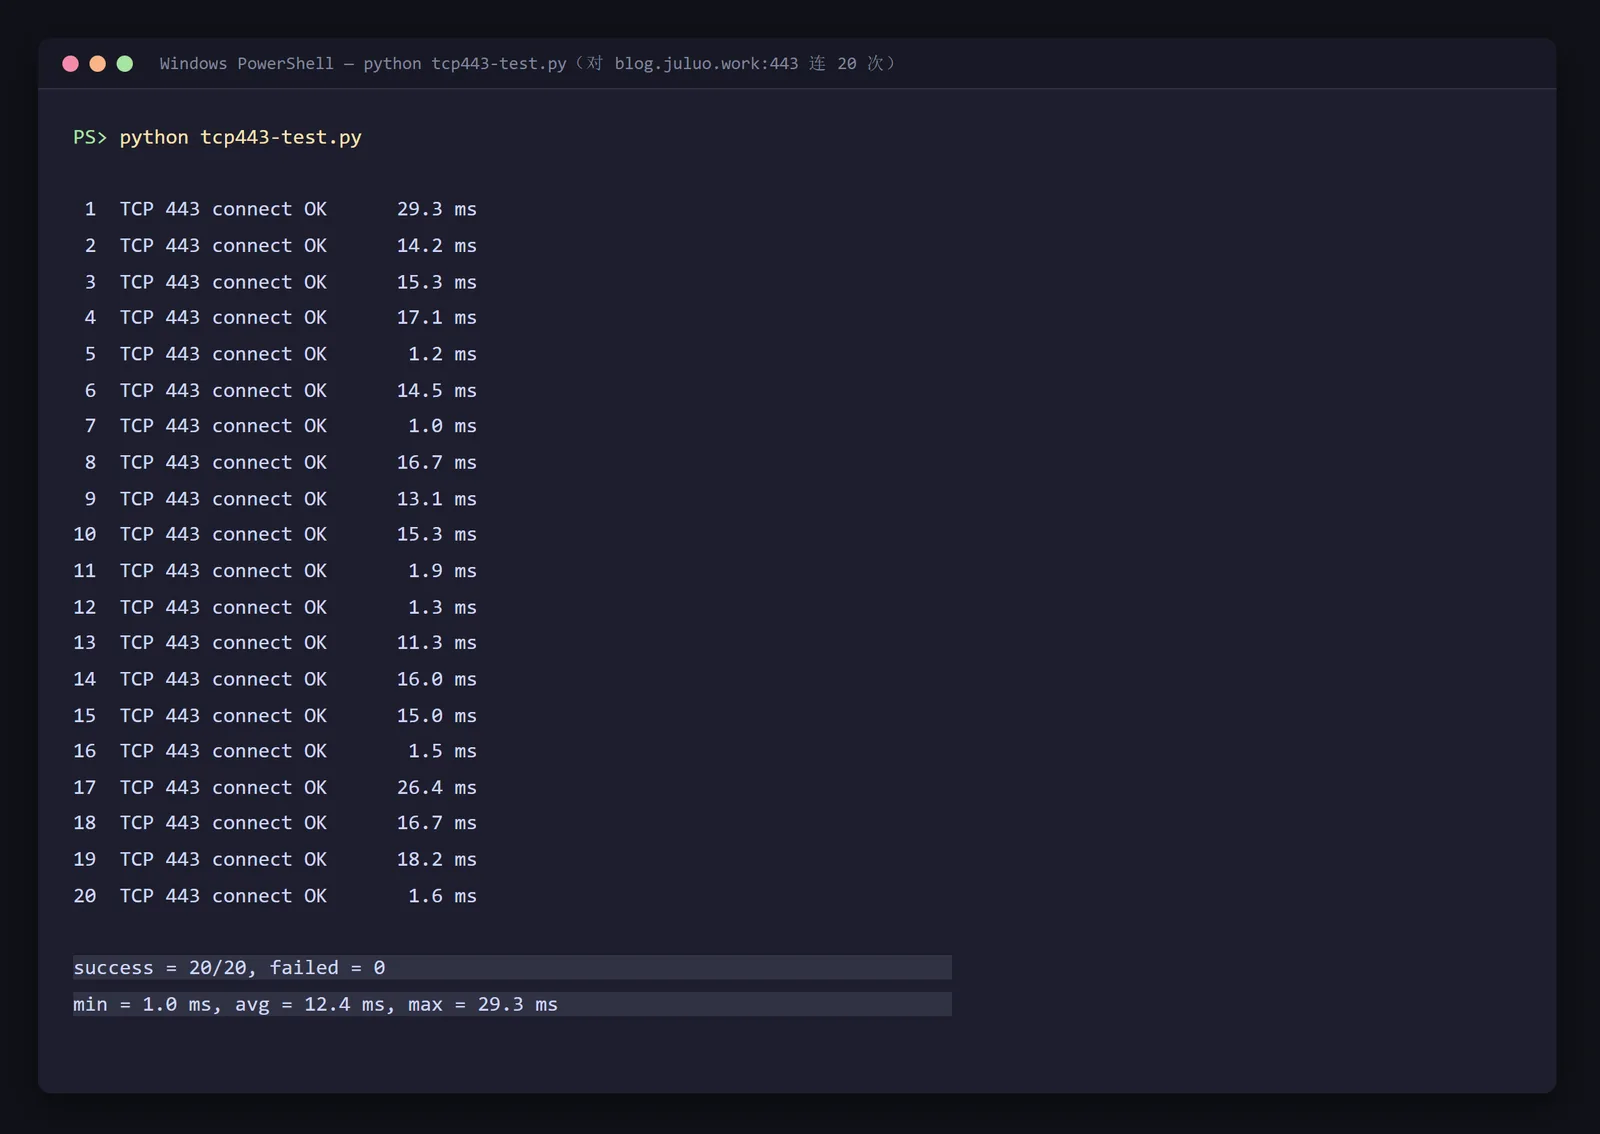
20 次全部成功,最快 1.0ms。
1.0ms 是什么概念?从本机到最近的中国香港机房,物理距离在 1000 公里以上,光在光纤里跑一趟就要 5ms 起步,往返一次 10ms 打底,一次 TCP 握手(SYN → SYN-ACK → ACK)不可能 1ms 完成。这个数字唯一合理的解释是:连接被本机代理栈直接终结了——代理先替远端回掉 SYN,再去慢慢建真正的连接。也就是说,这场测试测的是我的代理,不是我的博客。
警告这三组本机数据我照样放进文章,但它们的结论是反的:它们证明的是”在带 TUN 代理的机器上做网络测量,结果基本不可用”。排查网络问题时,先确认自己的测量点在哪一层,比多测几次更重要。
判据表:什么时候该管
把上面这些现象整理成一张表,下次再遇到”中间跳丢包”可以直接对照:
| 你看到的现象 | 大概率是什么 | 要不要管 |
|---|---|---|
| 中间某跳 90%+ 丢包,但漏回来的包延迟低且稳定 | 控制平面对 ICMP 限速 | 不用管 |
| 中间跳 100% 丢包(连 IP 都不显示) | 设备被配置为不响应 TTL 超时(沉默设备) | 不用管,看它后面的跳有没有回包 |
| 中间跳丢包,同时该跳延迟明显抬高、最快最慢差距很大 | 可能是真拥塞,也可能是限速叠了偶发排队 | 先观察,最终按末跳定论 |
| 末跳(目标 IP 自己)持续丢包 > 5%,且延迟抖动明显 | 真丢包:边缘节点异常或链路拥塞 | 要管 |
| 从某一跳开始延迟阶梯式上升(如 24ms → 207ms) | 路由绕路 / 出境,不是丢包 | 想优化延迟才管 |
| 只有 ICMP 丢包,TCP 业务正常(页面能开、SSH 不断) | ICMP 被策略丢弃或限速 | 不用管 |
| ICMP 和 TCP 同时丢,并且有用户报障 | 真故障 | 立刻管 |
配套的三条实操建议:
- 以末跳为准。中间跳只提供”路径长什么样”的信息;能不能通,只看最后一跳是不是目标 IP、有没有回包。Windows 自带的
tracert每跳只发 3 个包,样本太少,看丢包率基本没有意义。 - 多打几次、多换源。每跳发 100 个包的 mtr 式工具(tcptest.cn 的路由追踪就是这种)比
tracert可靠得多。换一个检测点再看:如果只有部分中间跳丢、末跳一致正常,基本可以定性为限速。 - 直接问业务端口。TCP 握手能否成功、TTFB 多少,才是用户真正感知到的东西。ICMP 只是尽力而为的旁证,从来不是指标。
那这次到底要不要管
不必。
- 末跳丢包 10%、平均 196ms,目标可达,业务侧 TCP 连接正常;
- 87%
99% 的那几跳,延迟只有 2124ms,是最典型的控制平面限速特征,没有任何拥塞迹象; - 唯一真实存在的问题,是第 15 跳之后从 24ms 涨到 207ms 的出境绕路——这属于 Cloudflare 免费套餐 + Anycast 的固有代价,和”丢包”是两件事,上一篇已经算过这笔账,暂时不动它。
小结
- traceroute 的”丢包率”是 ICMP 回包率,不是转发丢包率。中间跳丢 99%,和你的网页能不能打开没有直接关系。
- 区分限速与真丢包的关键:漏回来的包延迟是否正常。延迟低而稳 = 限速;延迟高而抖 = 拥塞。
- 只有末跳(目标自己)持续丢包,才轮到”该管”这两个字。
- 测量前先看自己的测量点在哪一层:一个 TUN 代理就能让 traceroute 只剩一跳,让 TCP 握手变成 1ms。
提示数据与截图说明:多节点路由追踪数据为 2026-10-05 晚在 tcptest.cn 实测(福建泉州电信节点,每跳 100 个包,完整结果见上面的 tcptest.cn 路由追踪结果);本机
tracert、ping -n 20与 TCP 连接测试均为同一晚在本机执行的真实输出,未做任何改动。由于本机 TUN 代理会让tracert只剩一跳,原计划做的”本机多目标 tracert 对比”拿不到任何中间跳数据,中间跳的分析因此改用 tcptest.cn 的节点侧追踪结果。
同属「工具输出怎么读」的另一篇是 SSL Labs 评分:一个看网络路径,一个看 HTTPS 配置。
发现错误或想要改进这篇文章?
在 GitHub 上编辑此页文章修订历史 (1 次)
查看变更记录
docs(baseline): 第 30 轮终检——数字更新到最终状态,补第 28~30 轮小结
相关文章
- 给每篇文章加「更新记录」:用 git 提交历史自动生成文章修改时间线文章页底部那块「更新记录」不是手写的:构建前用脚本读 git log 生成 JSON,页面再按 slug 查表渲染。本文拆开这条链路,讲清 fetch-depth 0 为什么是硬前提、浅克隆会怎样把一条无关提交按到所有文章头上,以及行内 diff 编辑器的取舍。
- SSL Labs 给我博客打了个 B:HTTPS 配置到底被扣在哪用 SSL Labs 给 blog.juluo.work 做真实体检:四个边缘节点全部评 B,唯一扣分项是服务端仍接受 TLS 1.0/1.1。本文记录评分怎么读、怎么用 openssl 在本机复现结论,以及逐项判断哪些扣分值得修。
- 我的博客响应头缺了什么:Cloudflare _headers 补课记用 securityheaders.com 体检博客,结果是 F:六个安全头全缺。这篇记录实测现状,讲清每个头的作用与副作用,并给出 Cloudflare Workers 静态资源用 public/_headers 补头的方案。